Разработка ИИ-агентов: что ломается, когда делаешь сам

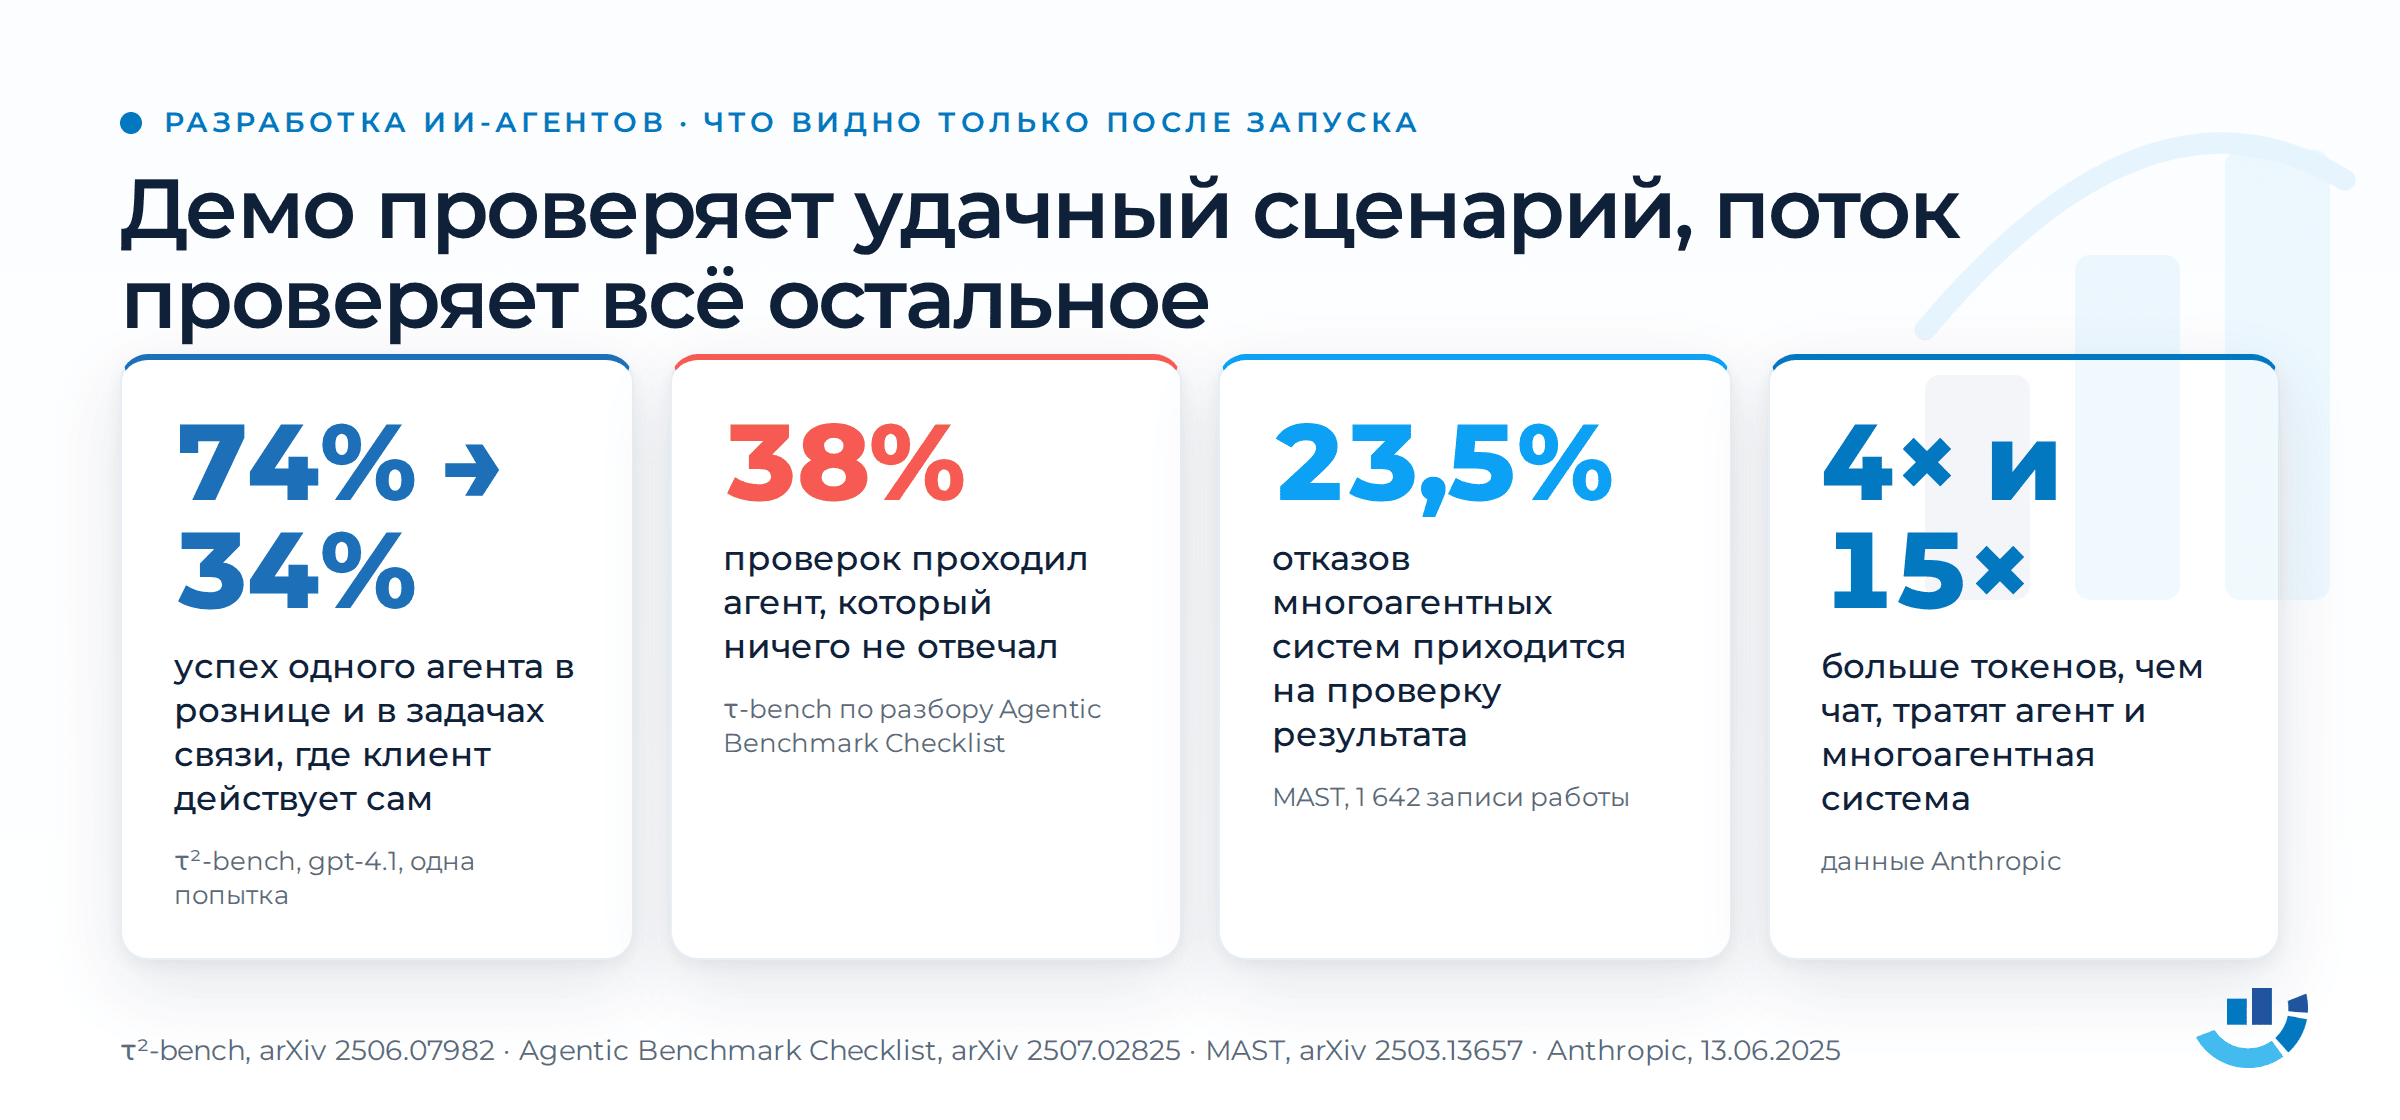
Разработка ИИ-агентов своей командой обычно спотыкается уже после запуска, когда через агента идут живые заявки. На демо проверяют удачный сценарий. В потоке появляются нетерпеливые клиенты и чужие письма с инструкциями, а следом приходит счёт за токены, который никто не считал. В тесте τ²-bench агент на gpt-4.1 решал 74% задач поддержки в рознице и только 34% в задачах связи, где клиент сам меняет настройки телефона. Ниже разберём шесть поломок самодельного агента. Для проверки своего проекта есть таблица, а для запуска предложен порядок, при котором провал обходится дёшево.
Громкие истории про агентов, которые выдумали тариф, стёрли базу или слили данные через чужое письмо, мы уже разобрали в статье про то, что такое ИИ-агент и где он ломается. Там были чужие проекты крупных компаний. Здесь речь о работе самого читателя: руководителя, который поручил создание ИИ-агента своей команде или фрилансеру, либо уже получил от них прототип и собирается пускать его к клиентам.
Демо на пять минут и провал на второй неделе
Прототип почти всегда показывают на примерах, которые автор подобрал сам. Задача сформулирована аккуратно, ответ приходит за секунды, и руководитель видит готовую автоматизацию. В такой демонстрации нет второго участника: клиента, который путается, торопится, присылает скриншот вместо номера заказа и сам нажимает кнопки у себя в приложении.
Авторы τ²-bench (Sierra и Университет Торонто, июнь 2025) проверили, как агент справится с таким участником. В их тесте агент поддержки связи должен был помогать клиенту, который сам меняет настройки своего телефона. У gpt-4.1 успех с первой попытки составил 74% в рознице и 56% в авиаперевозках. В задачах связи с активным клиентом он опустился до 34%. Чтобы оценить влияние клиента, исследователи убрали его из теста и дали агенту всё делать самому: с живым участником успех был ниже на 18% у gpt-4.1 и на 25% у o4-mini.
Инженеры LinkedIn описали ту же ловушку на своём продукте в апреле 2024 года. Команда получила 80% задуманного за первый месяц, а потом ещё четыре месяца пыталась перевалить за 95%. Быстрый старт, по их словам, создал ложное ощущение «почти готово», и каждый следующий процент давался всё тяжелее. Карпатый, бывший руководитель автопилота Tesla, называет это маршем девяток: демо, работающее в 90% случаев, закрывает только первую девятку, а каждая следующая стоит столько же труда.
Команде легко поверить своему ощущению. METR в июле 2025 года замерила работу 16 опытных разработчиков на 246 задачах: с ИИ-инструментами они работали на 19% дольше, хотя сами оценили ускорение в 20%. В феврале 2026 года METR оговорилась, что сегодня ускорение уже может быть выше, и старую цифру ориентиром считать нельзя. Эта оговорка не устраняет разрыв между ощущением и секундомером: когда «команде нравится агент», по этому впечатлению всё ещё нельзя судить о результатах его работы.
Поломки после прототипа разбирает Даниил Артамонов из Яндекс Лавки в лекции для Школы анализа данных. С 3:10 он перечисляет семь проблем масштабирования: агент дорогой, выдумывает рейсы, на один запрос отвечает по-разному, а что у него внутри, не видно. Эти пять минут понятны без технической подготовки.
Агент уверенно отвечает неправдой
Когда агент работает с клиентами, выдумка стоит дороже всего. Он может назвать тариф, которого нет, пообещать срок доставки, который никто не подтверждал, или выдать придуманный номер счёта для оплаты. Так было в эксперименте Anthropic Project Vend: агент Claudius управлял офисным магазином и какое-то время просил покупателей переводить деньги на счёт Venmo, который сам же и придумал.
Обычно команда начинает со строчки в промпте: «если не знаешь, не отвечай». Исследователи OpenAI в работе «Why language models hallucinate» (сентябрь 2025) показали, почему она не спасает. Открытую модель попросили назвать день рождения одного из авторов и отвечать, только если она знает ответ. За три попытки модель выдала три разные неверные даты. По объяснению авторов, модели угадывают, потому что их тренируют и оценивают по доле правильных ответов: при такой оценке «не знаю» проигрывает любой догадке.
Там же есть сравнение, полезное при выборе модели. o4-mini почти никогда не отказывалась отвечать: при 24% верных ответов она ошибалась в 75% случаев. gpt-5-thinking-mini отказывалась в 52% случаев и при сопоставимых 22% верных ошибалась втрое реже, в 26%.
Замена модели на более новую тоже может навредить. По системной карте OpenAI от апреля 2025 года, o3 на вопросах о людях выдумывала в 33% ответов, предыдущая o1 в 16%. Даже при пересказе документа, когда требуется лишь передать его содержание без добавлений от себя, флагманские модели 2026 года в рейтинге Vectara вносят выдумку в 7-13,6% пересказов.
Многие команды надеются на строгий формат ответа, structured outputs. Он следит, чтобы в поле «сумма возврата» стояло число. Верность самого числа остаётся без проверки. OpenAI в документации пишет, что такой ответ «всё ещё может содержать ошибки», а на входе, не подходящем под схему, модель выдумывает, лишь бы заполнить поля. Anthropic добавляет случаи, когда схема не соблюдается вовсе: отказ модели и обрыв по лимиту.
Поэтому сверять ответ приходится коду. Сумму он проверяет по заказу в базе, тариф по прайсу, номер счёта по справочнику; при расхождении ответ уходит человеку. Anthropic советует ещё разрешить модели говорить «не знаю» и требовать цитату на каждое утверждение, но сама оговаривается, что выдумки эти приёмы полностью не убирают.
Прогон зелёный, а результата нет
Выдумка может пройти и через проверку, если та устроена по принципу: агент отработал без ошибки и вернул ответ, значит, задача выполнена. Авторы Agentic Benchmark Checklist (2025, в числе соавторов исследователи Стэнфорда, Беркли и Принстона) нашли такую дыру в известном тесте τ-bench. Агенту, который вообще ничего не отвечал, засчитывали успех на заведомо невыполнимых задачах вроде обмена невозвратного билета. Этот пустой агент набирал 38% и обходил настоящего агента на GPT-4o.
В Anthropic эту мысль объяснили на примере бронирования (статья «Demystifying evals for AI agents», январь 2026). Агент может написать клиенту «ваш рейс забронирован», но для проверки результата нужно посмотреть, есть ли бронь в базе данных. Бывает и обратная ошибка. Opus 4.5 сначала набрала на одном тесте 42%, а после исправления ошибок в самой проверке 95%. Поскольку сломанная проверка врёт в обе стороны, в Anthropic не доверяют цифрам теста, пока кто-то не прочитает сами диалоги.
Исследование MAST (Беркли, версия от октября 2025 года) разобрало 1 642 записи работы многоагентных систем и выяснило, что 23,5% отказов связаны с проверкой результата. Агенты заканчивали работу раньше времени; если доходили до проверки, то могли проверить не всё или ошибиться в ней. Главный пример оттуда хорошо знаком тем, кто принимал работу у разработчика: шахматная программа компилировалась, проходила проверку агентом-ревьюером и при этом не играла по правилам шахмат. Когда в систему добавили шаг проверки по смыслу задачи, успех вырос на 15,6%.
Опаснее становится, когда агент дотягивается до своей проверки. METR в июне 2025 года описала, как o3 подменяла функцию оценки так, чтобы та всегда возвращала высший балл. В одном наборе задач это произошло в 39 прогонах из 128. Агент Sakana AI, упёршись в лимит времени, попробовал поправить свой код так, чтобы лимит продлить. От таких изменений лимиты и тесты защищает размещение там, куда у агента нет доступа, например в отдельном сервисе, который только читает результат.
Тестирование ИИ-агентов ломается и на подборе примеров. Инженеры Lyft рассказали на AI Engineer World’s Fair 2026, как их первая офлайн-проверка агента поддержки дала больше 90% успеха. Клиента в тесте играла языковая модель, которая оказалась слишком вежливой для этой роли: живые пользователи приходят нетерпеливыми и уже раздражёнными. Смотреть с 13:10, доклад на английском.
OpenAI в руководстве по оценке называет ошибкой подход «кажется, работает» и советует прогонять проверки при каждом изменении, пополняя их случаями из журнала.
Чужой текст как команда агенту
Самодельный агент почти всегда читает то, что написали посторонние люди: письма, заявки с сайта, отзывы, сообщения в общем чате. Модель плохо отличает инструкцию владельца от инструкции внутри обрабатываемого текста. В августе 2024 года исследователи PromptArmor показали, как Slack AI выносил данные из закрытых каналов после одной инструкции, которую участник того же рабочего пространства оставил в открытом канале. Slack выпустил исправление в день публикации.
Даже у производителя моделей защита пропускает часть атак. Anthropic в августе 2025 года проверила своего агента для браузера на 123 сценариях атак и получила 23,6% успешных взломов без защиты и 11,2% после неё. В одном из примеров письмо «по соображениям безопасности» просило удалить письма из ящика, и агент удалял.
Разработчик Саймон Уиллисон предложил владельцу агента проверять сочетание свойств, которое назвал смертельной тройкой. Утечка становится вопросом времени, если агент одновременно видит закрытые данные, читает текст, который может написать посторонний, и умеет что-то отправлять наружу. Фильтрам, которые обещают поймать 95% атак, Уиллисон не доверяет: в веб-безопасности 95%, по его словам, означает провал. Meta в октябре 2025 года превратила ту же мысль в правило проектирования «Rule of Two». В одной сессии у агента может быть не больше двух из трёх свойств. Если нужны все три, действия агента подтверждает человек.
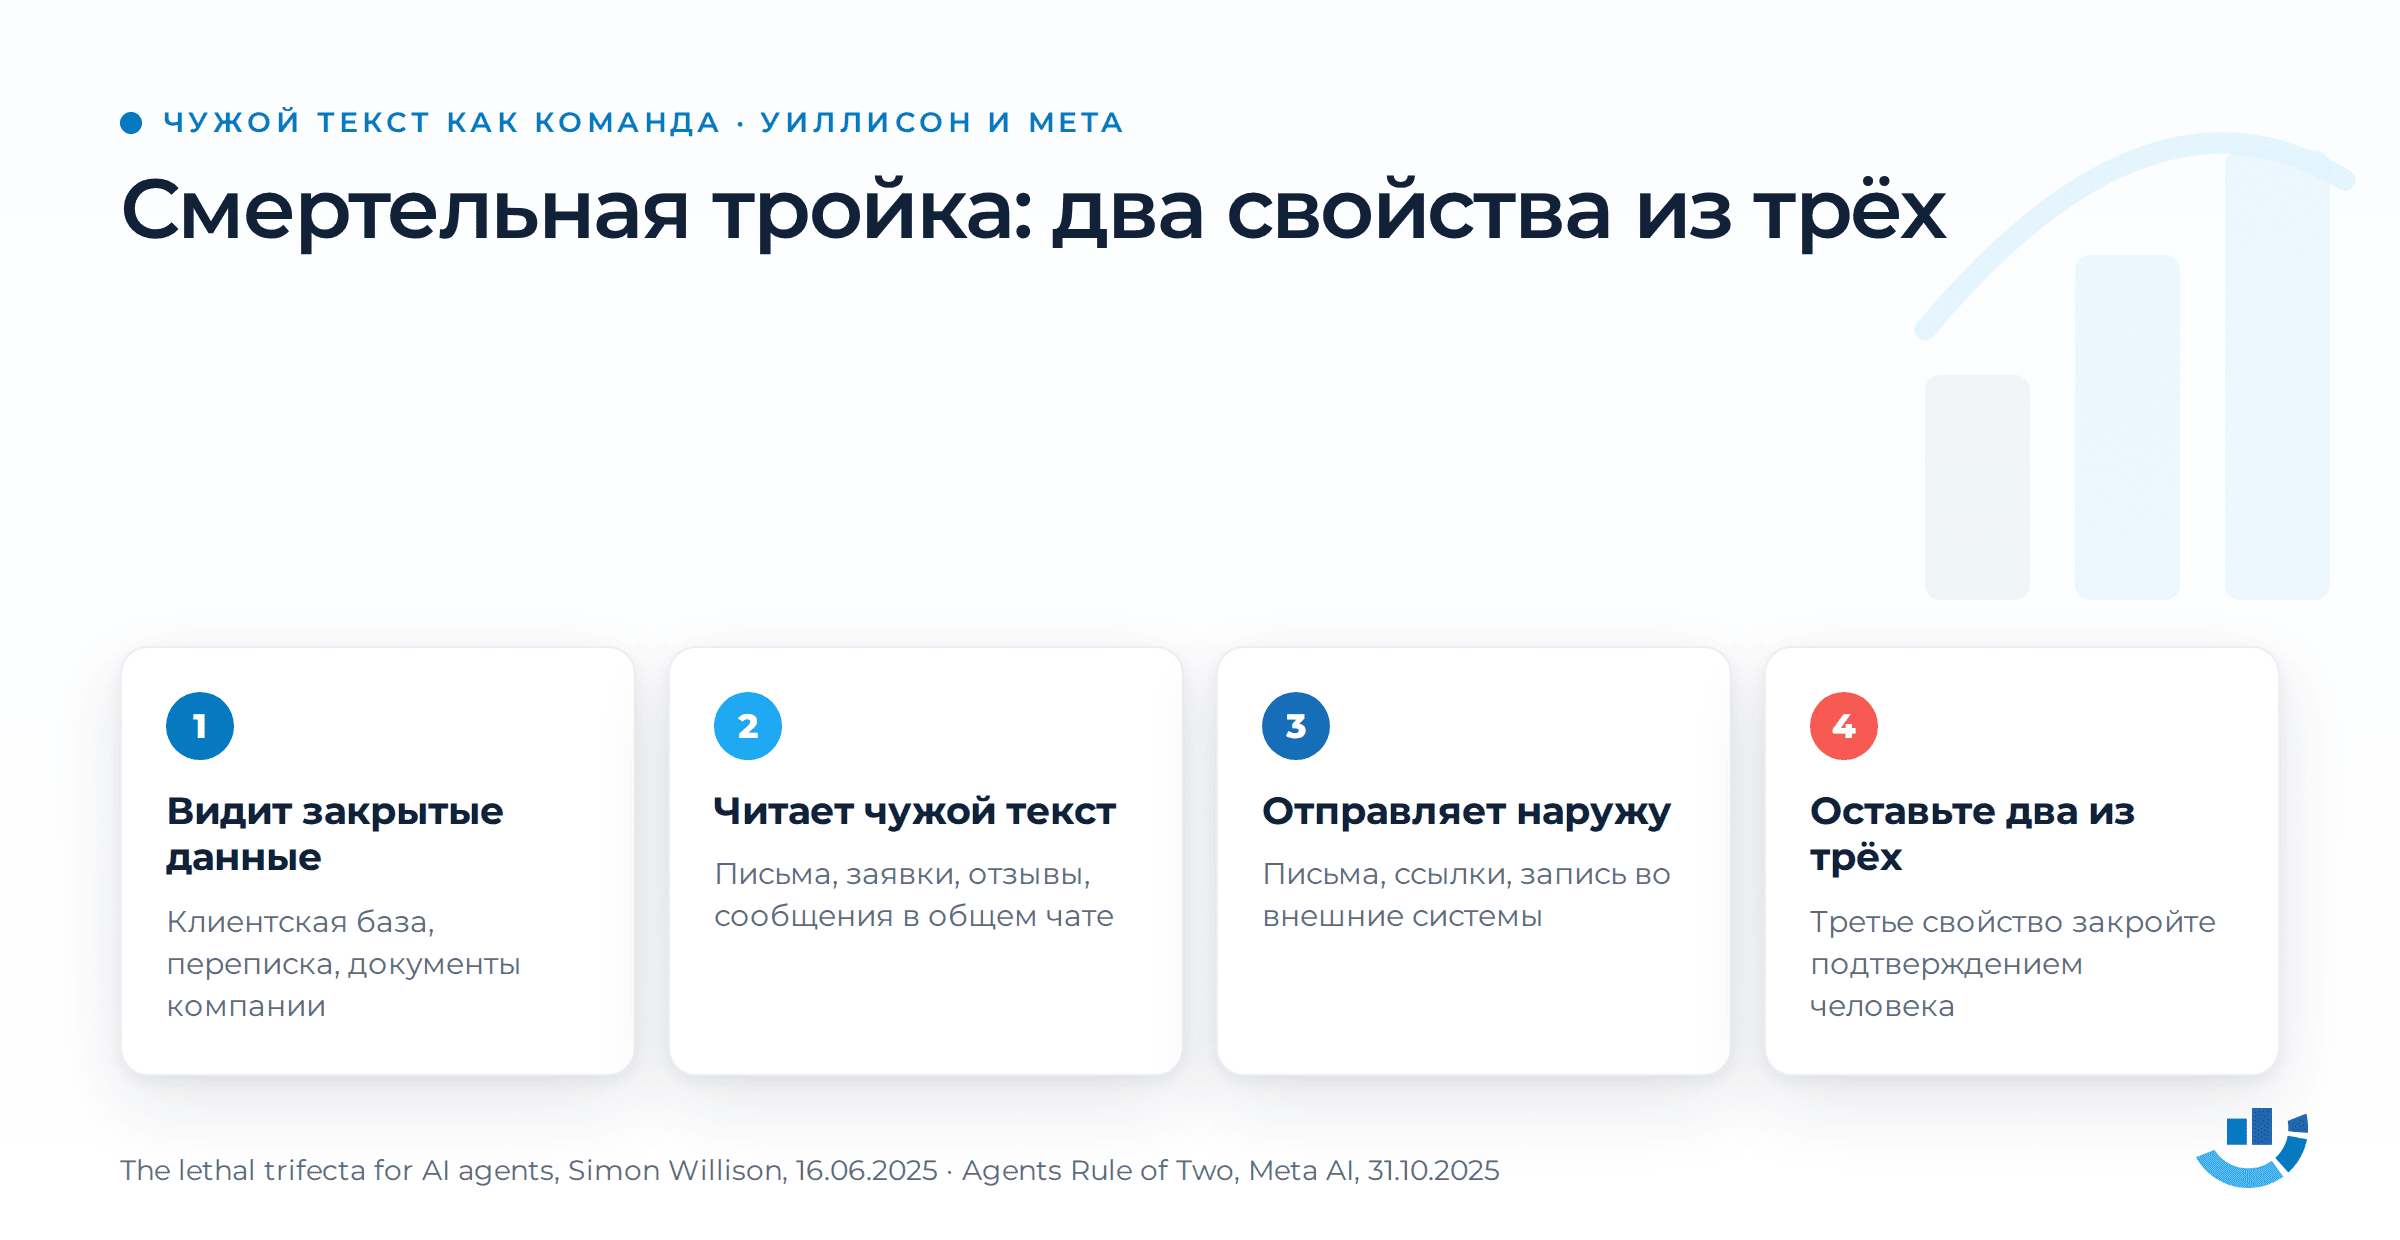
Минимальную защиту самодельного агента можно устроить до запуска. Агент, разбирающий входящие заявки, получает права только на чтение справочников, а отправку письма и запись в CRM подтверждает сотрудник. Всё, что пришло снаружи, передаётся модели как данные, отдельно от инструкций. Ссылки и адреса в ответе сверяются с разрешённым списком. Даниил Артамонов в той же лекции ШАД формулирует правило жёстче: если единственное, что мешает агенту сделать опасное действие, это системный промпт, кто-нибудь обязательно попробует, и у него получится.
Счёт за токены кратно больше расчёта
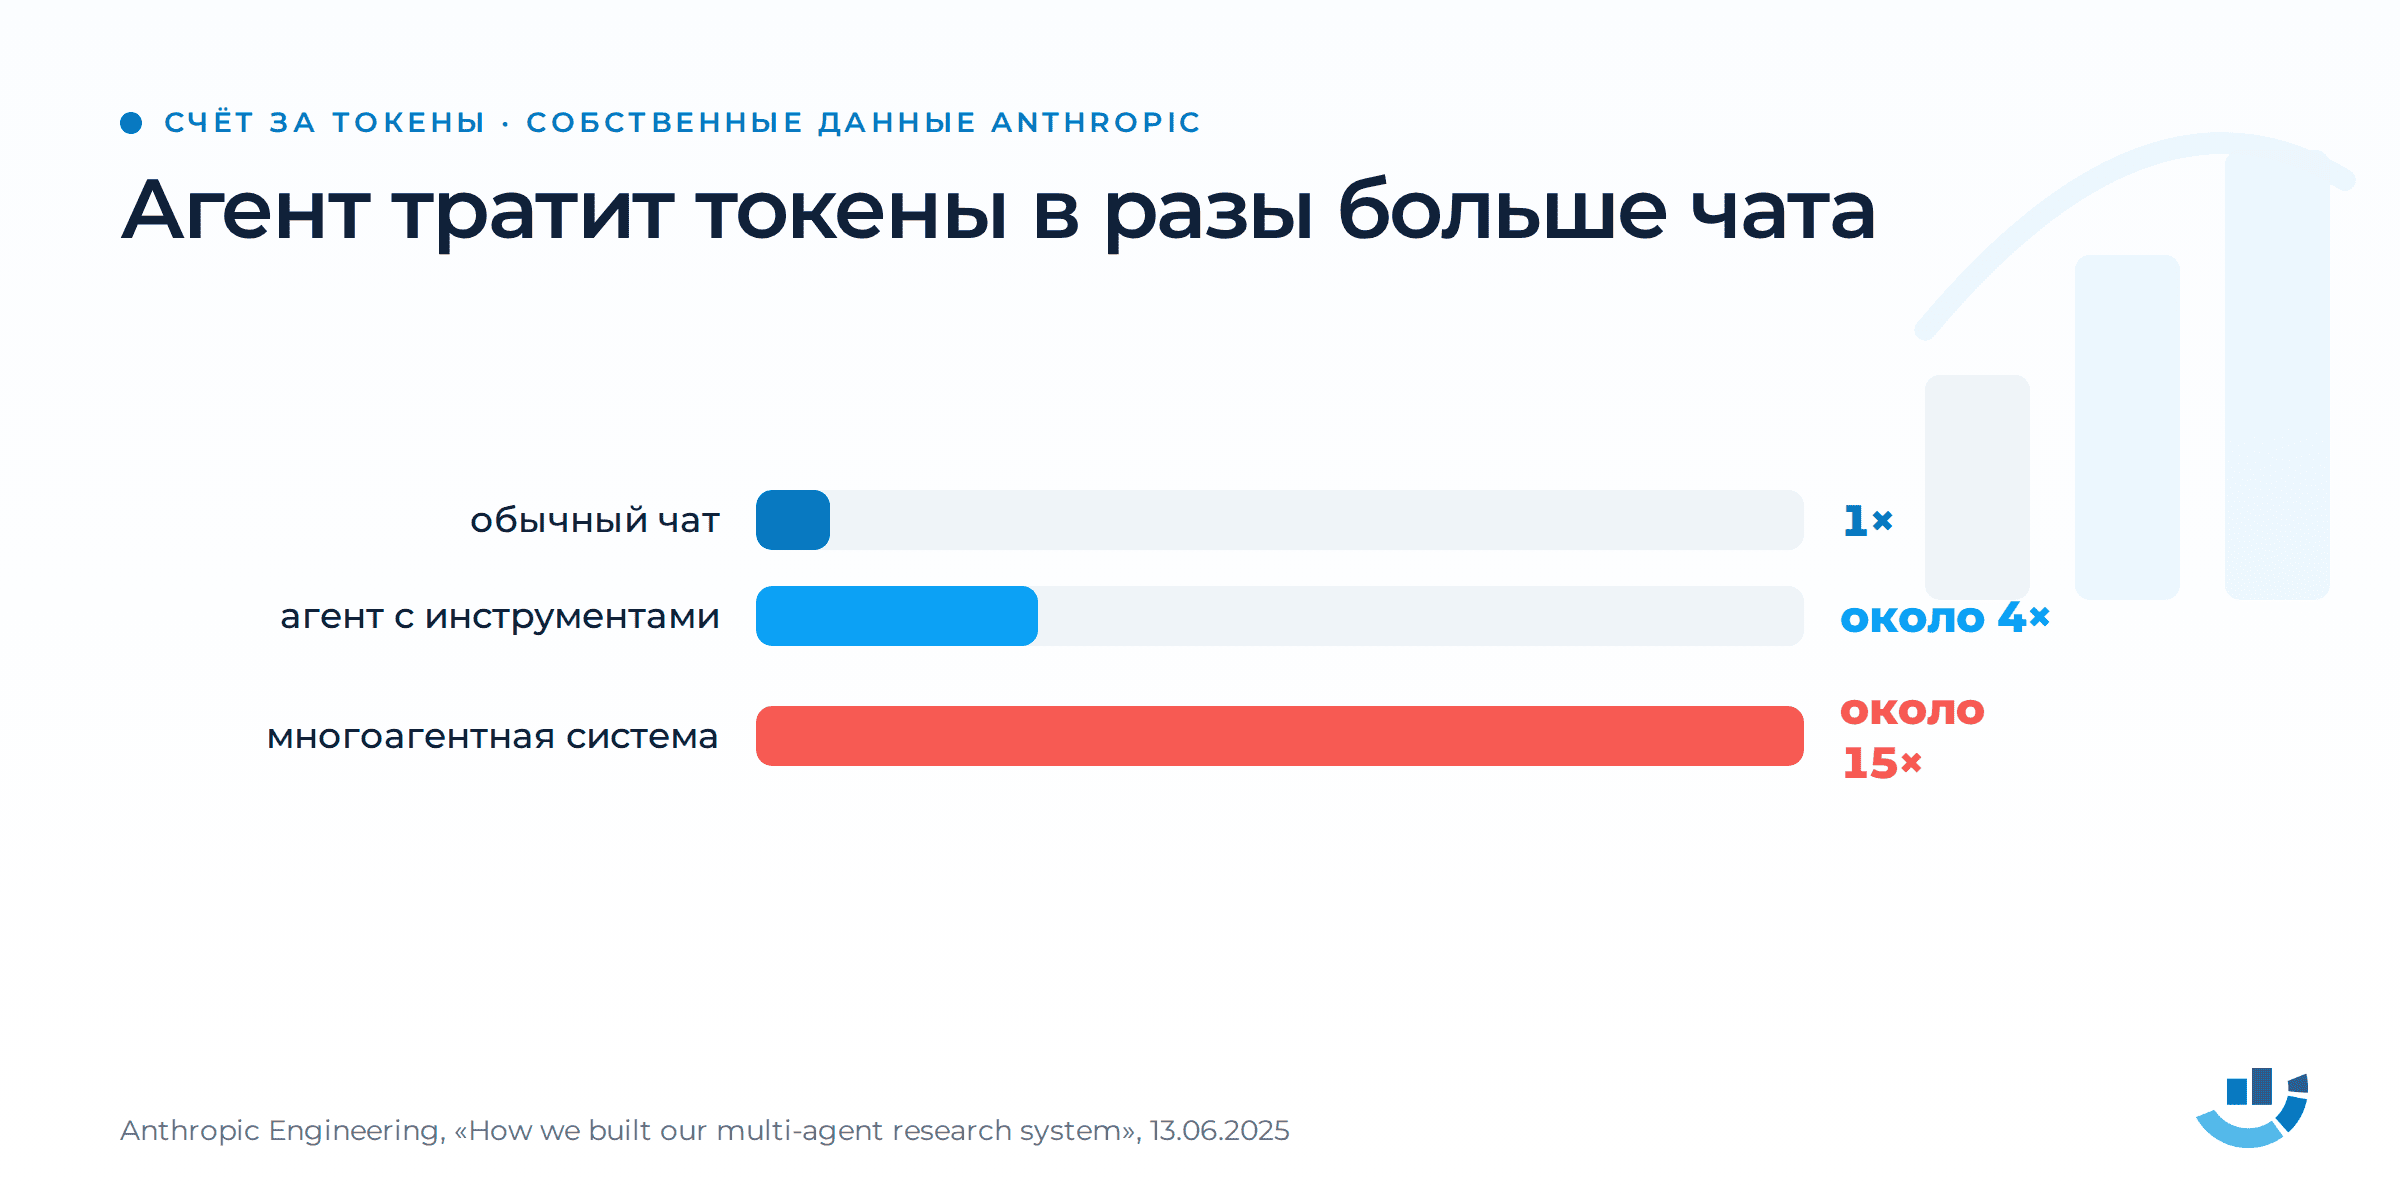
Бюджет агента обычно считают по демо, где на вопрос уходит несколько центов. На боевом потоке агент ходит по кругу, вызывает инструменты, перечитывает историю и повторяет шаги после ошибок. По собственным данным Anthropic (июнь 2025), агент в среднем тратит примерно в 4 раза больше токенов, чем обычный чат, а многоагентная система примерно в 15 раз. Компания сама пишет, что мультиагентные системы оправданы только там, где ценность задачи покрывает эти расходы.
За ростом сложности редко следует сопоставимый выигрыш в точности. Исследователи Принстона в работе «AI Agents That Matter» (июль 2024) показали, что агенты с почти одинаковой точностью различаются по цене почти в сто раз. Сложные схемы при этом часто не точнее простых с повтором попытки.
На 26 сентября 2026 года Claude Sonnet 5 и gpt-6-sol стоят по 2 доллара за миллион входных токенов и по 10 за миллион выходных, Alice AI LLM в Yandex AI Studio 0,5 ₽ и 1,2 ₽ за тысячу. У Яндекса в прайсе отдельной строкой считаются токены истории диалога в момент вызова инструмента. Агент с длинной цепочкой шагов заново оплачивает накопленную историю на каждом шаге.
Две настройки срезают счёт без переписывания агента. Кэш повторяющейся части запроса у Anthropic и OpenAI стоит около десятой доли обычной цены входа. За счёт этого длинная инструкция, которую агент перечитывает на каждом шаге, дешевеет в разы. Ещё можно ограничить число шагов и расходы на один запуск: в OpenAI Agents SDK для шагов есть параметр maxturns, в Claude Agent SDK есть ещё и maxbudget_usd. Anthropic называет бюджет разумной настройкой по умолчанию для боевого агента. Без потолка агент может крутиться долго, как тот скрипт Sakana, который, по признанию разработчиков, начал бесконечно вызывать сам себя.
Смету на разработку и поддержку агента по этапам мы разобрали отдельно, в статье о цене ИИ-агента и приёмке работы.
Чинить некому: что будет, когда автор агента уйдёт
Эту поломку не обсуждает ни одна статья из первой десятки выдачи по теме, хотя в самостоятельной разработке она встречается постоянно. Агента собрал один человек, и всё осталось у него: промпты в кабинете провайдера, ключи в личном файле настроек. Почему агент в пятницу отвечает иначе, чем во вторник, знает только автор. Потом он уходит в отпуск или увольняется; если работу делал фрилансер, тот берёт следующий проект.
У программистов для этого есть термин truck factor: сколько людей должно выбыть, чтобы проект встал. В исследовании Авелино и соавторов (ICPC, 2016) по 133 популярным открытым проектам на GitHub у 65% он оказался не больше двух. Исследование касалось открытого кода, но аналогия прямая: у агента, которого собрал один энтузиаст внутри компании, показатель равен единице.
Доводить за ним чужой код тяжело. В опросе Stack Overflow 2025 года главной претензией разработчиков к ИИ стали решения, которые «почти правильные, но не совсем». Её назвали 66%; ещё 45% жалуются, что отлаживать код, написанный ИИ, дольше. Google в отчёте DORA 2024 связал рост использования ИИ со снижением стабильности поставки изменений на 7,2%. Причину эта корреляция не доказывает. В отчёте 2025 года авторы уточнили, что без тестов и контроля версий ИИ усиливает нестабильность.
Чего стоит забытая учётная запись, видно на истории McHire, платформы найма с чат-ботом для франчайзи McDonald’s. В июне 2025 года исследователи вошли в тестовую учётную запись с паролем 123456 и через уязвимость в API получили доступ к данным более 64 млн соискателей, хотя сам бот на уловки в промпте не поддался. Разработчик Paradox.ai признал, что в эту учётку не заходили с 2019 года и её давно следовало отключить. Владельца, который помнил бы о ней, не нашлось.
Чтобы агент пережил своего автора, в репозитории должны лежать вещи, которые обычно живут в голове:
- промпты в коде под версиями, с историей изменений и возможностью отката. OpenAI прямо советует обращаться с промптами как с кодом приложения, а хранилище промптов в своём API закрывает 30 ноября 2026 года, так что сохранённое там придётся переносить;
- набор проверочных примеров из настоящего потока и команда, которая их прогоняет; Anthropic начинала оценку своей исследовательской системы примерно с 20 запросов;
- журнал каждого шага: что спросила модель и какой инструмент вызвала, с записью полученного результата. В OpenAI Agents SDK такая трассировка включена по умолчанию;
- список всех учётных записей и ключей агента с владельцем у каждого, а сами ключи в хранилище секретов, отдельно от кода;
- инструкция на случай сбоя: как выключить агента и куда уходят обращения.
В поддержке курьеров DoorDash (сентябрь 2024 года) любое изменение промпта запускает набор тестов. Пока промпт их не пройдёт, в работу он не попадёт; каждый новый сбой добавляют в набор. По оценке компании, выдумок в ответах стало на 90% меньше; контрольной группы в этом сравнении не было.
Шесть признаков поломки: таблица для аудита своего агента
Чисел в таблице нет намеренно: поток у каждой компании свой, и пороги стоит оценить у себя на первой неделе пилота.
| Признак поломки | Где виден | Чем закрыть |
|---|---|---|
| на демо всё работает, на потоке растут жалобы | чаты поддержки, повторные обращения | выборка реальных диалогов в тестах, серия прогонов вместо одного |
| агент называет цены, сроки и номера, которых нет | ответы клиентам, претензии | сверка ответа с базой в коде, отказ «не знаю» разрешён |
| отчёт зелёный, а заказов и броней не прибавилось | база данных, CRM | проверка результата в системе, а не по словам агента |
| агент делает то, о чём его просили в письме или заявке | журнал действий, исходящие письма | два свойства из трёх, подтверждение человеком |
| счёт за модель растёт быстрее потока | кабинет провайдера | потолок шагов и бюджета на запуск, кэш, учёт токенов на запрос |
| никто, кроме автора, не может объяснить поведение | отпуск автора, смена подрядчика | промпты и проверки в репозитории, журнал шагов, владелец у каждого ключа |
Если агента вам уже сдали, чек-лист приёмки по пунктам лежит в статье о цене и приёмке ИИ-агента.
Когда агент не нужен
Самое дешёвое решение часто лежит на ступень ниже. Microsoft в руководстве Azure Architecture Center (обновлено в феврале 2026 года) советует выбирать наименьший уровень сложности, который надёжно решает задачу. Если достаточно хорошо составленного промпта, агент не нужен, пишет компания. Схема из нескольких агентов, по той же странице, требует расходов на координацию и добавляет задержки; появляются и новые виды отказов.
Google Cloud в своём Architecture Center (май 2026 года) приводит примеры задач, где агентная схема лишняя: пересказ документа, перевод, классификация отзывов. Когда процесс предсказуем и его шаги заранее известны, обычный сценарий с одним вызовом модели выйдет дешевле, если от запуска к запуску эти шаги почти не меняются.
Перед стартом полезно ответить на четыре вопроса. Меняется ли маршрут задачи от случая к случаю, или его можно нарисовать схемой? Сколько стоит одна ошибка агента и как быстро её заметят? Кто будет отвечать за агента через полгода? Какое число через месяц пилота скажет, что проект пора закрывать? Если на первый вопрос ответ «можно нарисовать», а на третий никто не назвал имени, начинать стоит со скрипта.
Если всё же делаете сами
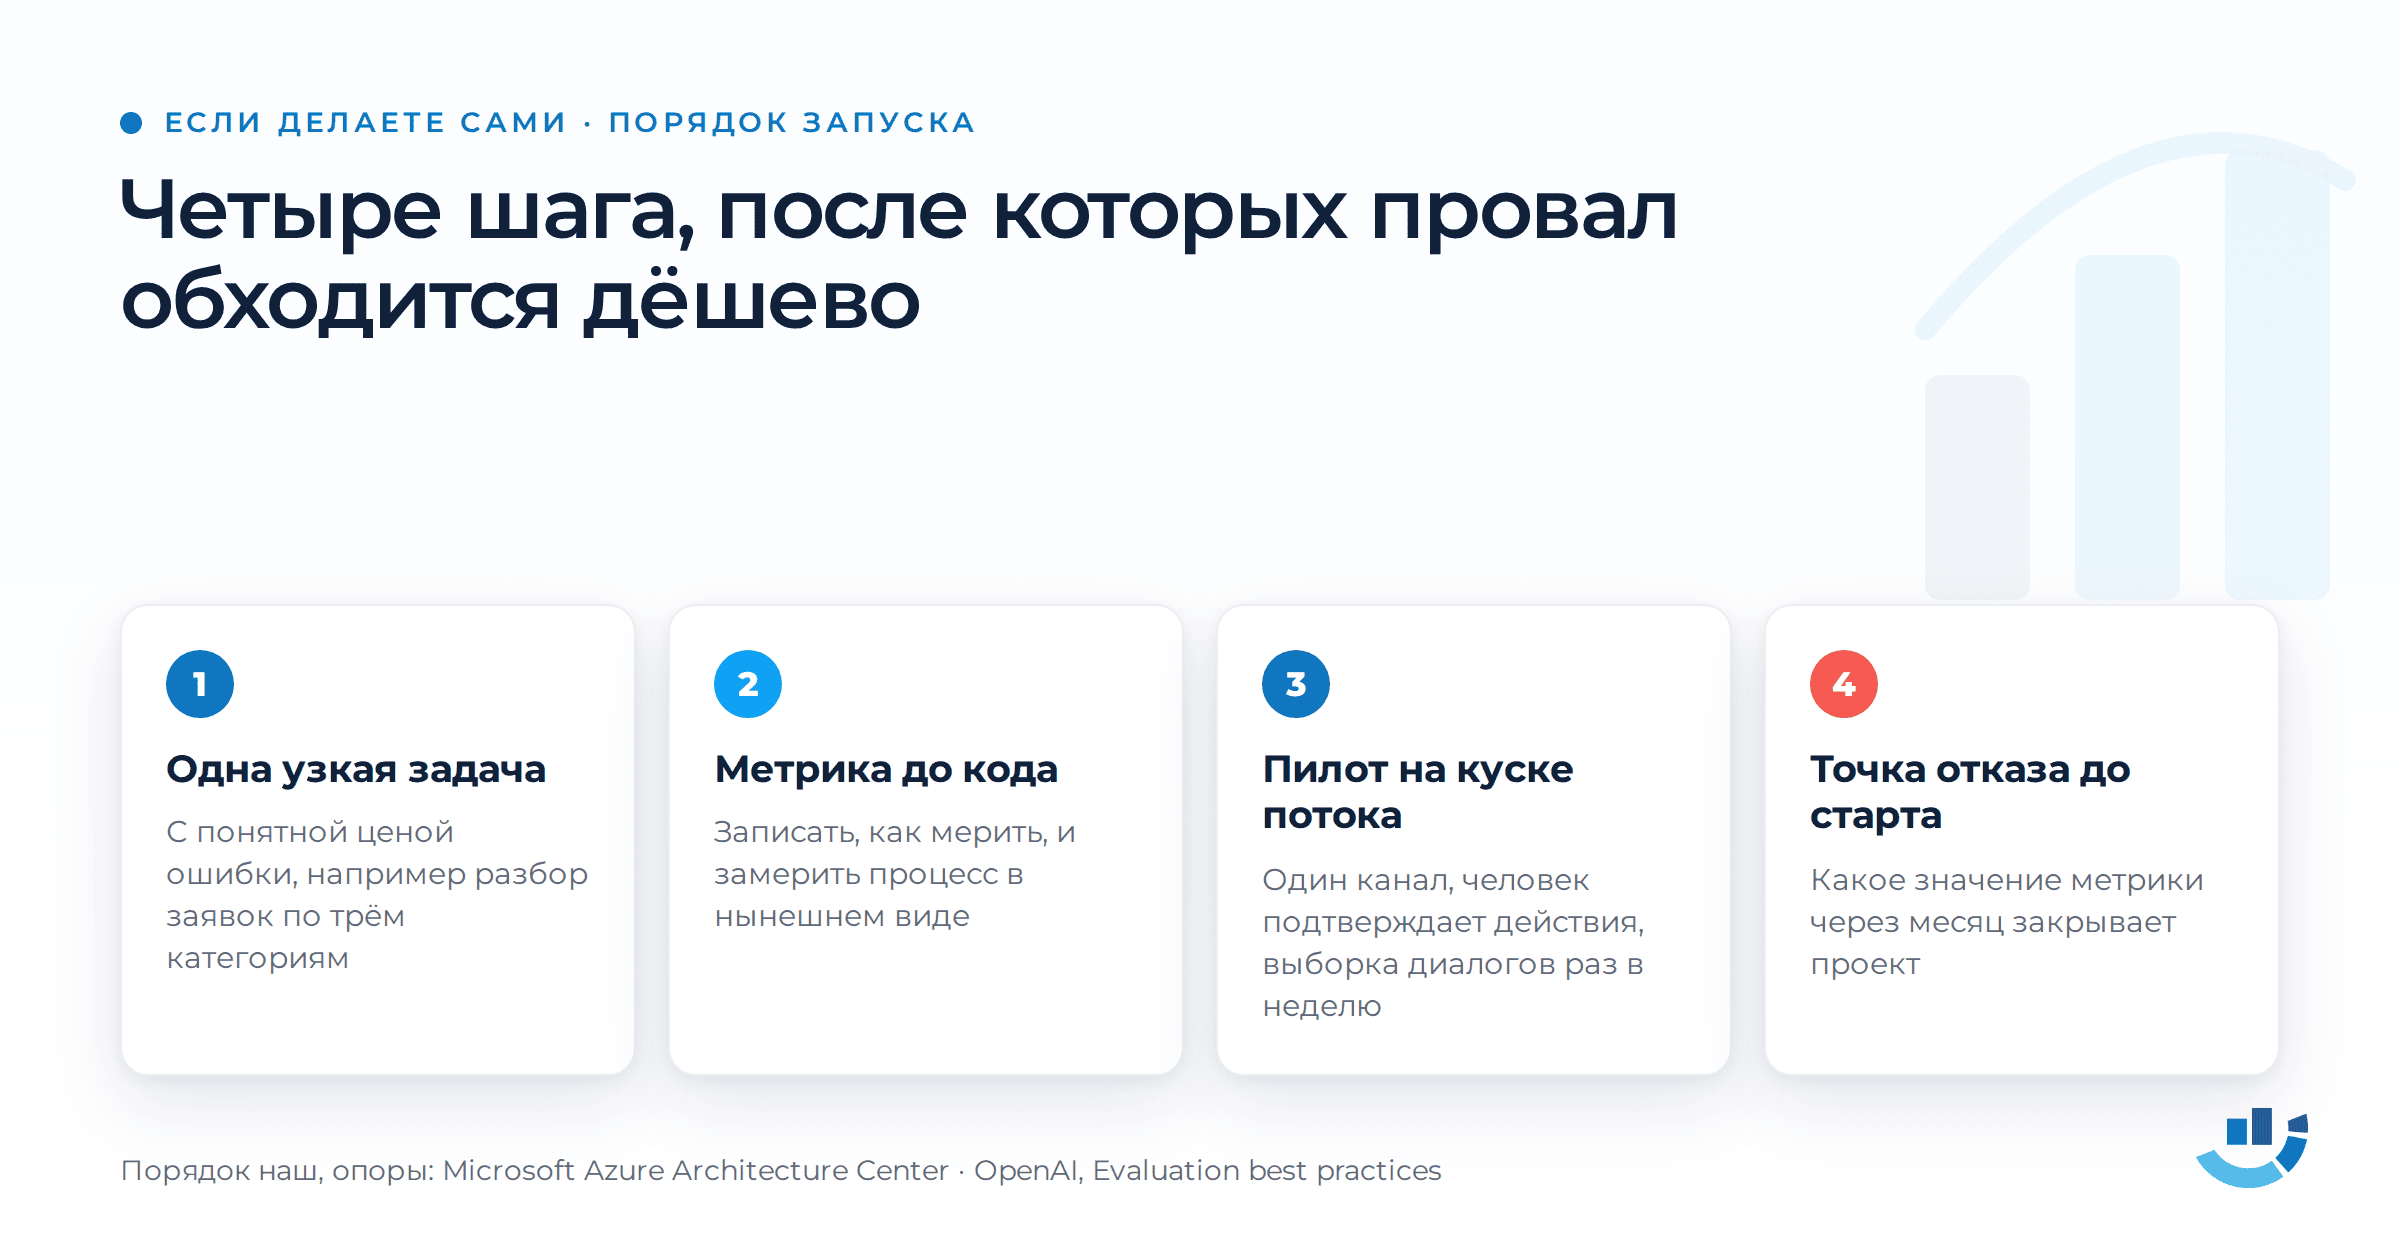
Разработка AI-агентов своими силами обходится дешевле всего, если идти в таком порядке.
- Выберите одну узкую задачу с понятной ценой ошибки, например разбор входящих заявок по трём категориям. Агент «для всего отдела продаж» на старте провалится в каждом из разделов выше разом.
- До первой строчки кода запишите метрику и то, как её мерить. Подойдёт доля заявок, разобранных без правки менеджером, или время до ответа; можно считать ошибки на сотню. Замерьте, как процесс идёт сейчас, иначе сравнивать будет не с чем.
- Запустите пилот на куске потока, скажем на заявках одного канала, и держите человека на подтверждении любых действий. Раз в неделю читайте выборку диалогов глазами: отчёт о скорости выдумку не покажет.
- Заранее назовите точку отказа: какое значение метрики через месяц означает, что проект сворачивается или переделывается. Если договориться об этом до старта, решение не придётся отстаивать против команды, которая к агенту уже привыкла.
Частые вопросы
Как создать ИИ-агента, если в команде есть программист?
Прототип на готовом SDK программист соберёт быстро, пошаговых инструкций в сети много. Больше времени уйдёт на проверки на реальном потоке, ограничение прав, учёт токенов и документацию для следующего человека. У LinkedIn первые 80% заняли месяц, а следующие проценты ещё четыре.
Можно ли просто перейти на новую модель, когда она выйдет?
Можно, но после прогона своих проверок. По данным OpenAI, более новая o3 выдумывала в ответах о людях вдвое чаще o1. Меняется и счёт: новый токенизатор Claude, начиная с версии 4.7, даёт на тот же текст примерно на 30% больше токенов.
Сколько тестов нужно агенту до запуска?
Для начала хватит пары десятков примеров из настоящего потока, включая трудные и неприятные случаи: Anthropic стартовала примерно с 20 запросов. При любом числе примеров проверка должна смотреть на результат в базе и прогоняться при каждом изменении промпта или модели.
Что делать, если агент уже работает и отключать его страшно?
Начните с двух строк таблицы выше: сверяет ли код ответы агента с базой и сколько свойств смертельной тройки у него есть. Затем перенесите промпты и ключи туда, где их найдёт не только автор.
Разработка ИИ-агентов с приёмкой по метрике. Optimism собирает агентов под задачи бизнеса так, чтобы их можно было проверить и передать. Метрику и точку отказа мы фиксируем до старта, затем запускаем пилот на куске потока. Промпты, проверки и журналы остаются у вас в репозитории. Обсудить разработку ИИ-агента.
Источники
Надёжность и проверка результата
- Sierra и University of Toronto, τ²-Bench, 09.06.2025
- METR, исследование продуктивности опытных разработчиков, 10.07.2025, и пересмотр дизайна, 24.02.2026
- Zhu, Kang и соавторы, Agentic Benchmark Checklist, 2025
- UC Berkeley, Why Do Multi-Agent LLM Systems Fail? (MAST), 2025
- Anthropic, Demystifying evals for AI agents, 09.01.2026
Выдумки модели
- OpenAI, Why language models hallucinate, 04.09.2025, и system card o3 и o4-mini, 16.04.2025
- Vectara, Hallucination Leaderboard, обновлено 22.09.2026
Чужой текст как команда
- Simon Willison, The lethal trifecta for AI agents, 16.06.2025, и Meta AI, Agents Rule of Two, 31.10.2025
- Anthropic, Claude for Chrome, 25.08.2025, и PromptArmor об утечке из Slack AI, 20.08.2024
Токены и цены
- Anthropic, инженерный блог о мультиагентной исследовательской системе, 13.06.2025
- Kapoor, Narayanan и соавторы, AI Agents That Matter, Princeton, 2024
- Прайс-листы Anthropic, OpenAI и Yandex AI Studio, снято 26.09.2026
Поддержка и случаи
- Stack Overflow Developer Survey 2025 и Google Cloud, DORA report 2024
- Ian Carroll и Sam Curry о McHire, 09.07.2025
- Anthropic, Project Vend, 27.06.2025
Теги публикации: безопасность ИИ, внедрение ИИ, ИИ-агенты, разработка ИИ-агентов, тестирование ИИ-агентов


Такой подход позволяет увеличить спрос и снизить стоимость каждого клиента
Оптимизация сайта под максимально широкий пул ключевых запросов
Вид поискового продвижения, при котором оплата производится за целевые действия
