Нейротекст: что Яндекс на самом деле считает мусором

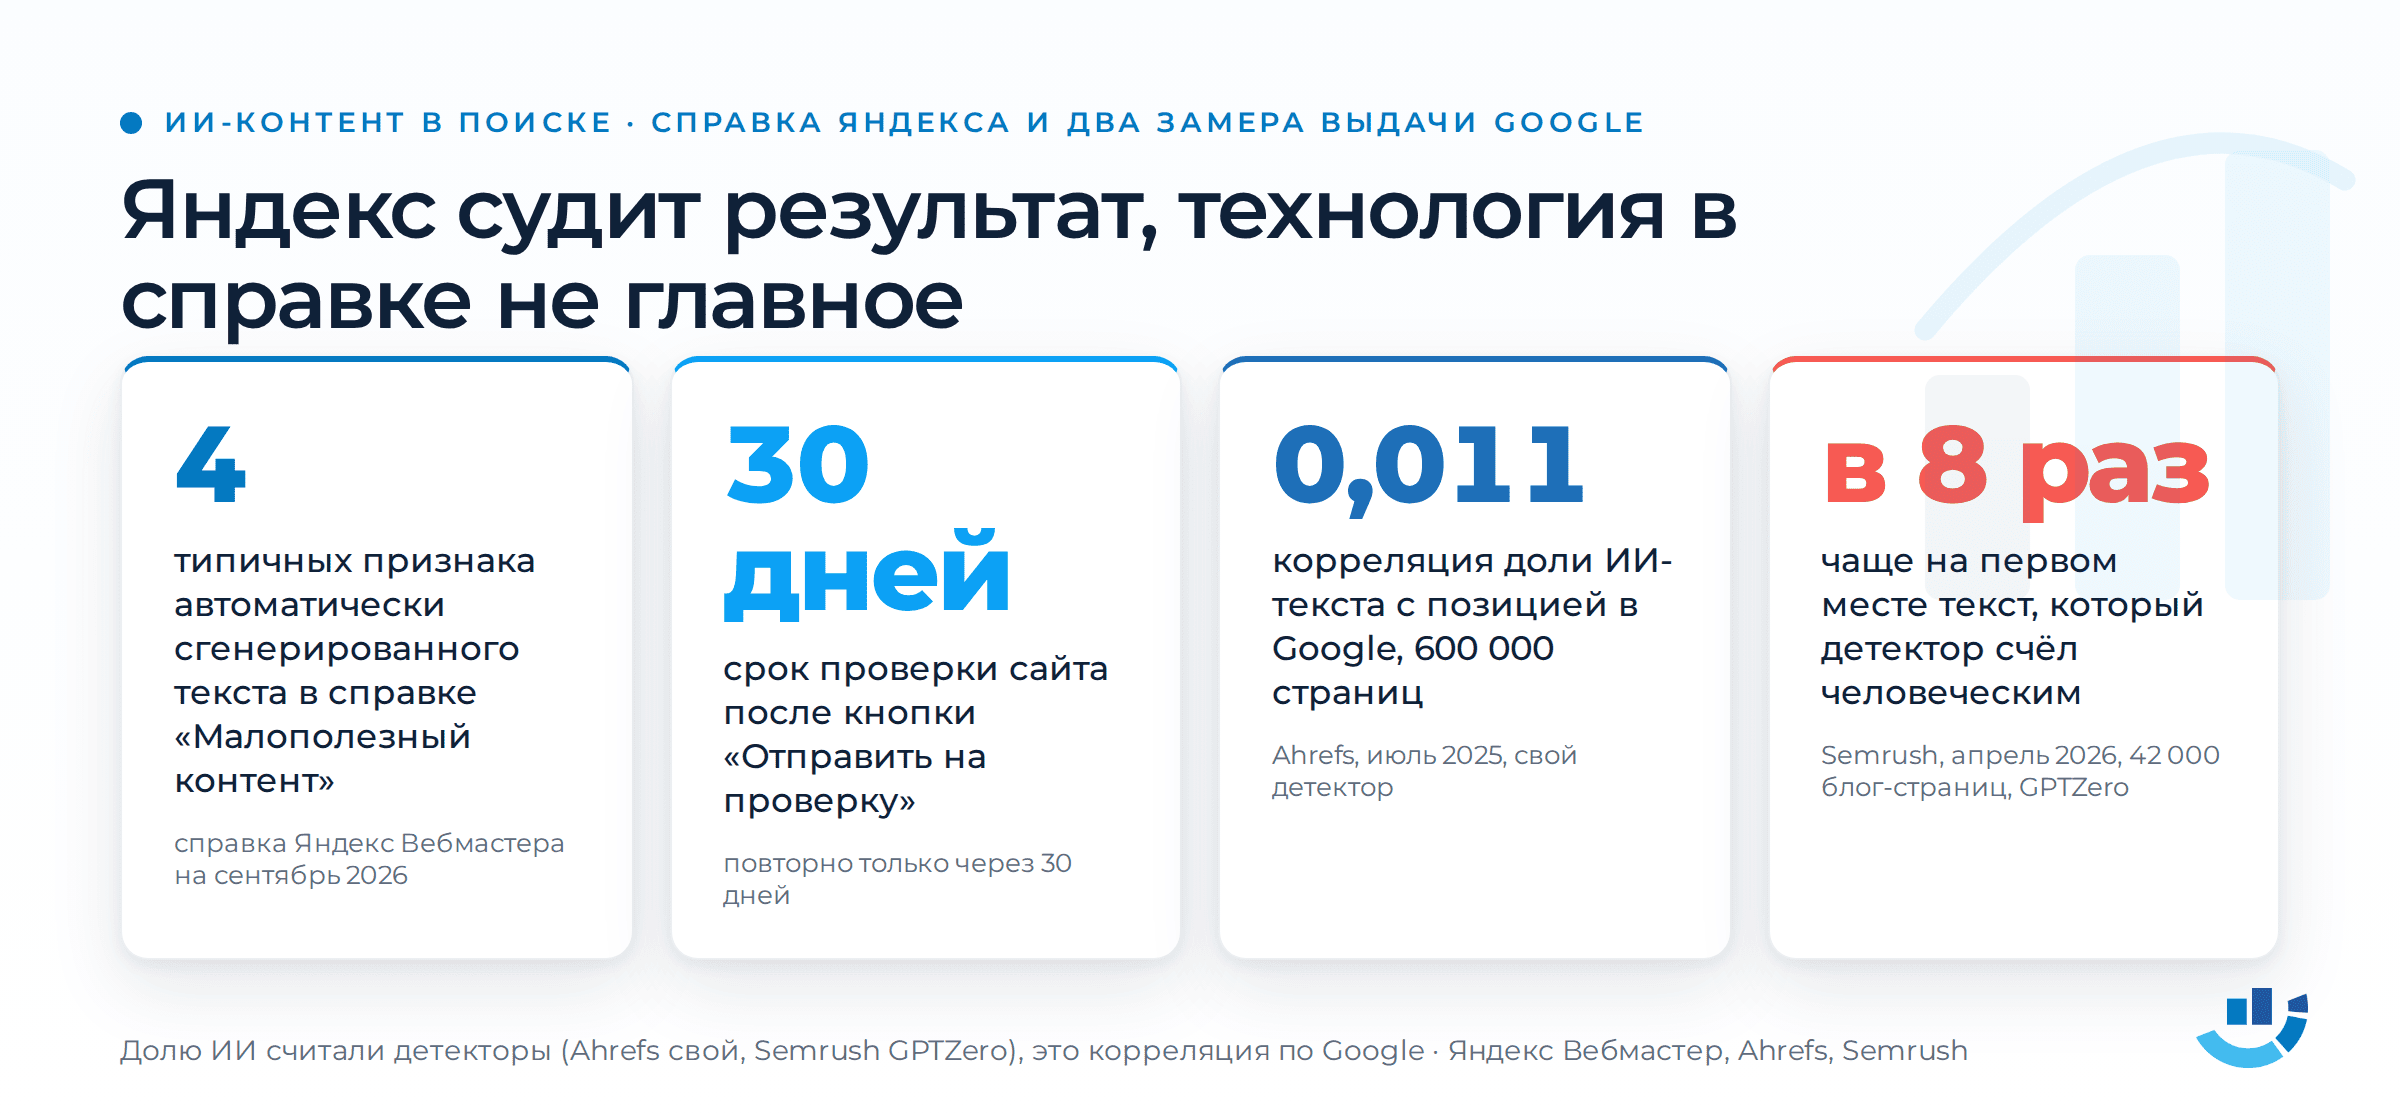
Нейротекст сам по себе Яндекс мусором не считает. Отдельной санкции за ИИ-контент в справке нет, а представитель Поиска прямо говорит, что использование нейросетей на ранжирование не влияет. Малополезным Яндекс называет текст, который уходит от темы, раздут ради объёма, пересказывает заголовок или выдаёт непроверенное за факт. Кто его написал, для справки значения не имеет: к работе модели, переводчика и копирайтера требования одинаковые. Ниже приведём признаки дословно и проверим по ним машинный абзац. Отдельно разберём, чего Яндекс малополезным не считает и почему страница может упасть без всякой метки в Вебмастере.
Что Яндекс называет малополезным контентом
Определение в справке Вебмастера умещается в одну строку: малополезным контентом считается «информация, которая не несет дополнительную ценность пользователю и не решает его задачу». Слов «нейросеть» или «искусственный интеллект» в определении нет. Они появляются ниже, в таблице признаков, рядом с другими способами получить текст без труда.
Таблица в справке «Малополезный контент» состоит из трёх строк. Дата редакции на странице не указана. Здесь пересказываем справку по состоянию на сентябрь 2026 года.
| Признак | Как его описывает Яндекс |
|---|---|
| Контент скопирован или переписан с другого ресурса | «Контент скопирован полностью или частично с других ресурсов». «Информация с нескольких страниц первоисточника собрана в одну». Материал скопирован «из меняющегося источника, например из результатов поисковой выдачи или ленты новостей». Информация взята «с минимальными изменениями (например, заменили несколько слов)» |
| Текст выглядит как автоматически сгенерированный или не несет дополнительной ценности | четыре типичных признака, о них в следующем разделе |
| Каталоги генерируются автоматически | каталоги товаров или услуг «созданы из автоматически полученных данных с других ресурсов»; на страницах «не работают категории и фильтры, нет сортировки товаров», есть «устаревшая или недостоверная информация» |
У слова «скопирован» на странице есть всплывающая подсказка. Она объясняет, что Яндекс имеет в виду: копирование названо способом создания контента, который «не требует затрат времени, усилий и специальных навыков, а также ручного редактирования или обработки текста». Под это описание одинаково подходят чужая статья, прогнанная через синонимайзер, и статья, которую модель выдала по одному запросу.
Масштаб тоже имеет значение. В блоге Вебмастера 5 октября 2023 года Яндекс уточнял: сайт получает нарушение, когда в нём «по-настоящему много заимствованного контента, агрессивной рекламы или спама», а «пара неоригинальных публикаций на большом ресурсе к наложению такой санкции не приведет».
Четыре признака машинного текста из справки
Вторая строка таблицы прямо называет нейросети. Приводим её целиком:
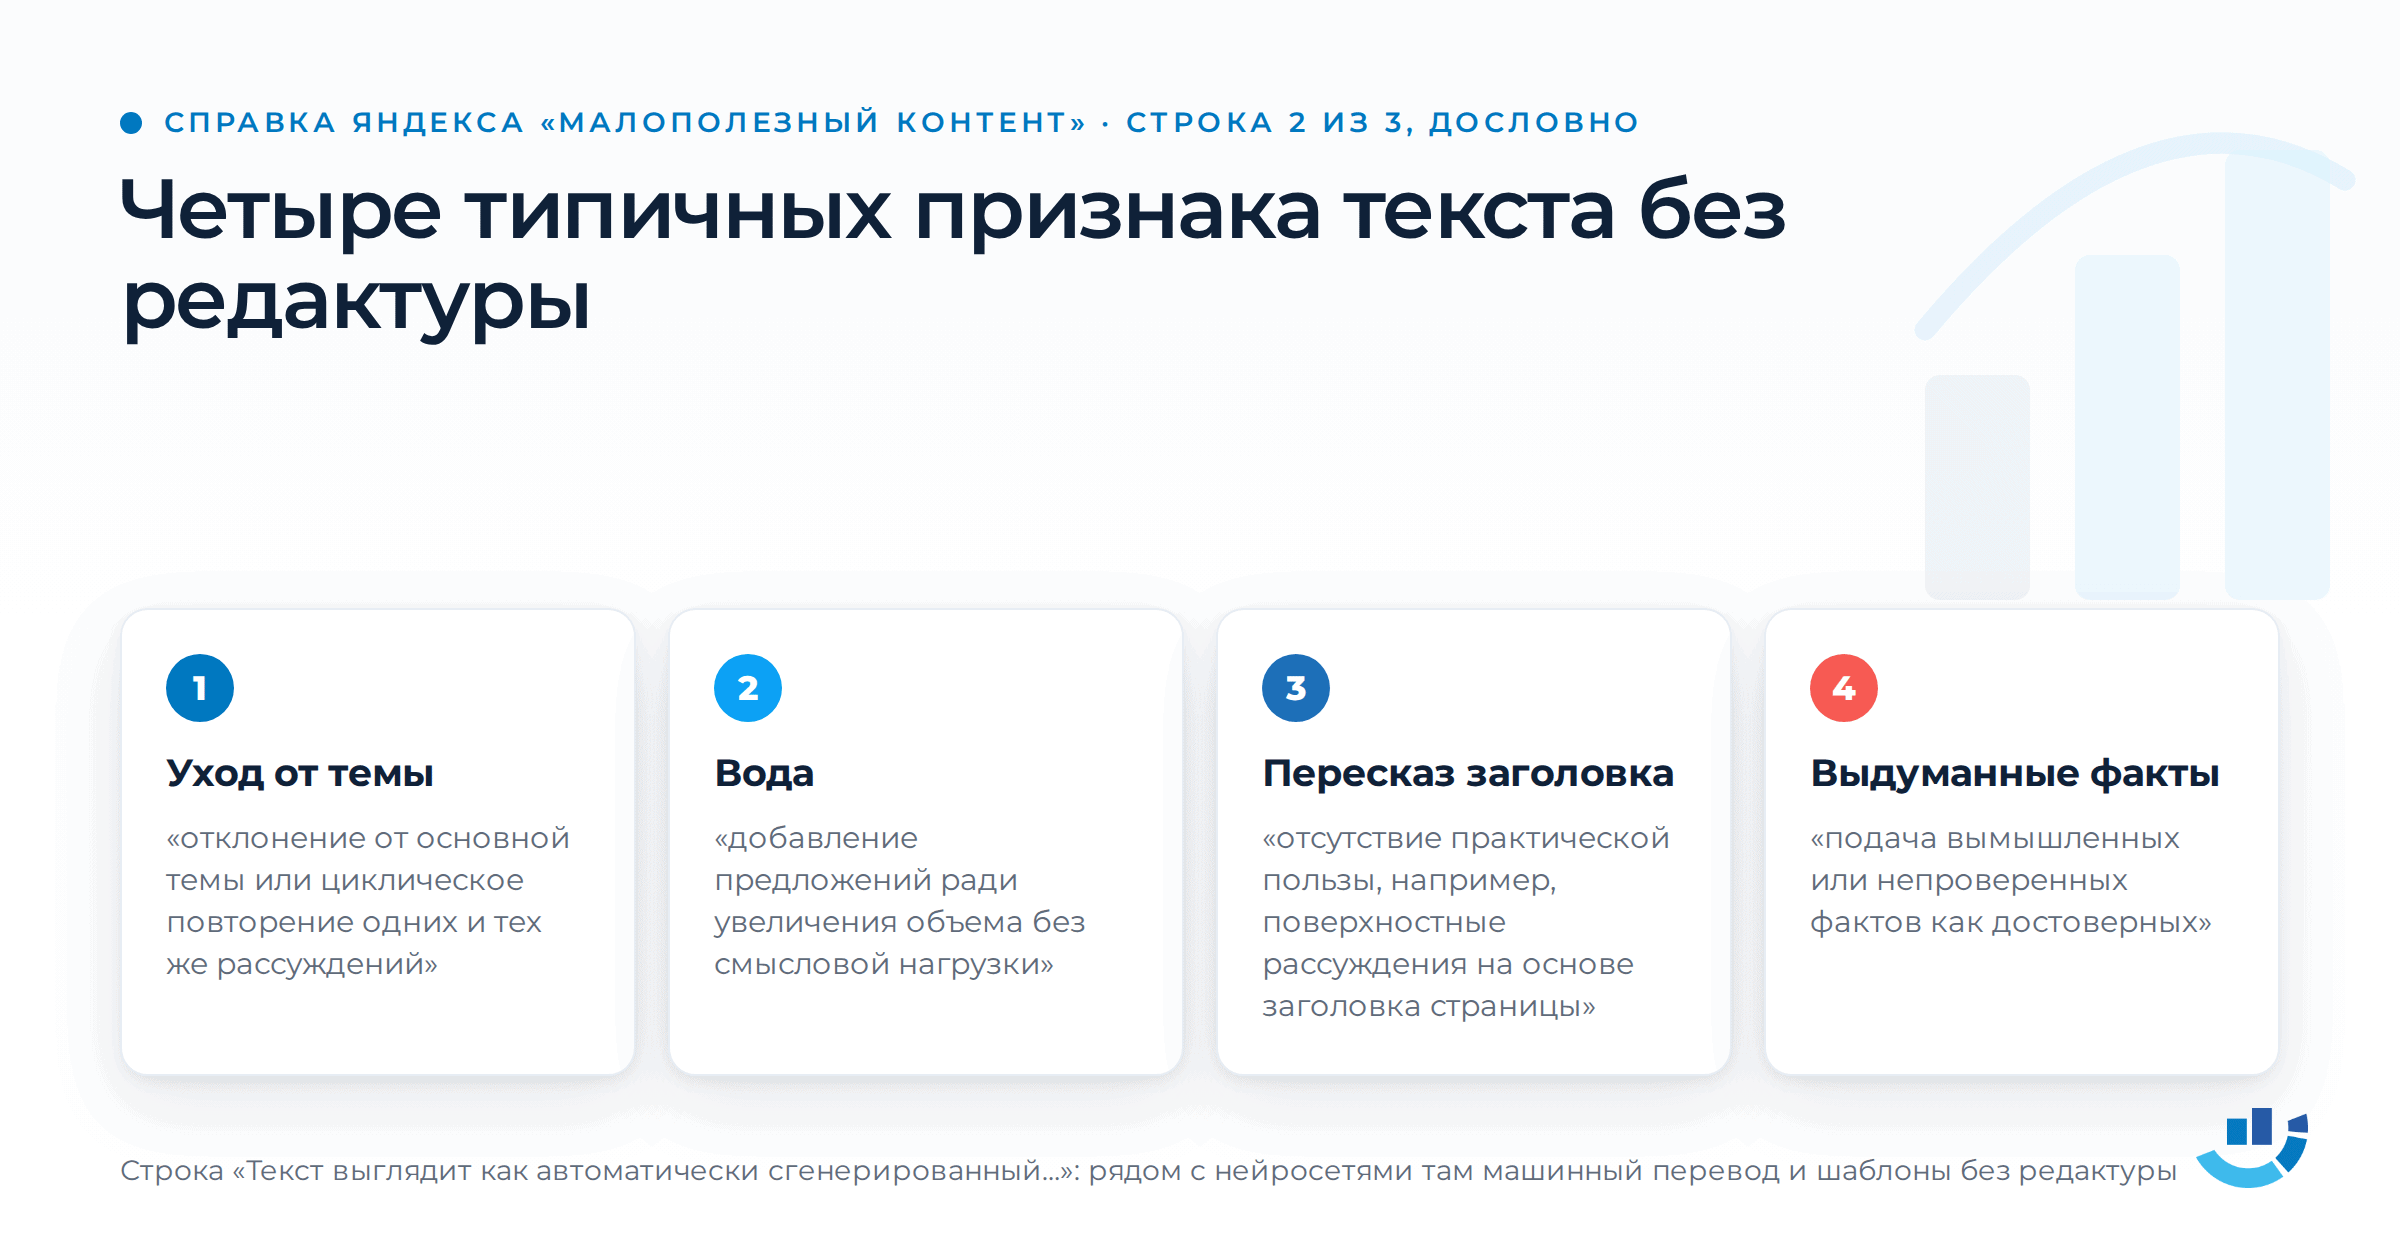
«Нередко такой контент создается с помощью нейросетей, машинного перевода или шаблонных методик (подстановок ключевых слов и фраз) без дополнительного анализа и редактуры. При этом текст формально может быть оригинальным, но оставаться малополезным для читателя.»
Дальше идут четыре типичных признака, тоже дословно:
- «отклонение от основной темы или циклическое повторение одних и тех же рассуждений»;
- «добавление предложений ради увеличения объема без смысловой нагрузки»;
- «отсутствие практической пользы, например, поверхностные рассуждения на основе заголовка страницы»;
- «подача вымышленных или непроверенных фактов как достоверных».
В первой фразе рядом с нейросетью стоят машинный перевод и подстановка ключевых слов по шаблону. Во всех этих случаях текст выпустили «без дополнительного анализа и редактуры». Признак описывает, как обошлись с текстом после генерации; какой программой он получен, Яндекс не спрашивает. Следующая фраза цитаты касается оригинальности: даже уникальный по сервису проверки текст может получить нарушение.
В статье про факторы ранжирования контента мы разбирали ЭПОС и приводили первый из этих признаков. Здесь нужны все четыре: по ним удобно проверять собственные тексты.
Как эти признаки выглядят глазами самого Яндекса, Михаил Сливинский показывал на Двенадцатой Вебмастерской 22 марта 2024 года. С отметки 6:14 он разбирает для зала живые страницы. Среди примеров есть ответ на вопрос про уколы с бессмысленным заголовком и текст о том, что студенты МГУ учатся в четвёртом классе. Ещё один пример: рассуждение об осени, которое выдача показывает по запросу про обои для iPhone. Примерно на десятой минуте Сливинский объясняет, что объединяет эти страницы: результат бессмысленный и не помогает пользователю. Получился ли он при автоматическом переводе, вышел из-под пера копирайтера или создан нейросетью без контроля качества, значения не имеет.
Проверяем нейротекст по четырём признакам
Абзац для разбора мы собрали сами специально для этой статьи. Мы воспроизвели манеру модели, которой дают только заголовок «Как выбрать кофемашину для офиса», без задачи и данных. Это учебный пример, придуманный нами от первого до последнего слова; текст с чужого сайта мы не брали.
Как выбрать кофемашину для офиса? Выбор кофемашины для офиса является важным решением для каждой компании. Кофе играет огромную роль в жизни человека, ведь история этого напитка насчитывает много веков. Правильно подобранная кофемашина для офиса делает работу сотрудников комфортнее, поэтому к выбору кофемашины для офиса нужно подходить ответственно. Учёные доказали, что свежесваренный кофе повышает продуктивность сотрудников. Именно поэтому при выборе кофемашины для офиса необходимо учитывать множество факторов, ведь от правильного решения зависит очень многое.
С грамматикой здесь всё в порядке, и сервис проверки уникальности покажет высокий процент. При этом в абзаце есть все четыре признака из справки Яндекса.
| Признак из справки | Где он в примере | Что сделал бы редактор |
|---|---|---|
| отклонение от темы или циклическое повторение | история напитка за много веков; «выбор кофемашины для офиса» пять раз за шесть предложений | убрал бы историю и оставил одну формулировку |
| предложения ради объёма | «подходить ответственно», «зависит очень многое» | вычеркнул бы: читатель из них ничего не узнал |
| поверхностные рассуждения на основе заголовка | абзац пересказывает заголовок и не называет ни одного критерия выбора | начал бы с вопросов: сколько человек пьёт кофе, какой бюджет, зерно или капсулы, кто будет мыть |
| вымышленные или непроверенные факты | «учёные доказали» без названия исследования | нашёл бы исследование или убрал фразу |
Для такого разбора не понадобилось гадать, писала ли абзац модель: все четыре признака видны при чтении. Детекторы машинного текста ошибаются в обе стороны. Признаки из справки полезнее процента «вероятности ИИ», поскольку по ним можно указать, чем именно текст плох для читателя.
Что Яндекс малополезным не считает
В той же справке есть список, который часто пересказывают с ошибкой. Приведём его дословно:
- «Оригинальные описания товаров, услуг, событий, организаций, компьютерных программ, инструкций к применению и руководств по эксплуатации.»
- «Тексты книг, песен, анекдотов, цитат и афоризмов.»
- «Официальные документы, законы, стандарты, шаблоны документов.»
- «Пресс-релизы.»
- «Собственные тексты сайта, опубликованные на других платформах (например, в социальных сетях).»
Ошибка возникает, если не учесть, где этот список стоит. Он вложен в строку «Контент скопирован или переписан с другого ресурса» и перечисляет исключения из правила о копировании. Например, описание от производителя или текст закона можно разместить на сайте, и за заимствование это не сочтут. То же касается своего поста из соцсети. Разрешения поручать карточки товаров нейросети в списке нет: сгенерированный текст карточки по-прежнему проверяется по четырём признакам из предыдущего раздела.
Исходную формулировку можно увидеть в блоге Вебмастера от 29 августа 2023 года. Там тот же список озаглавлен «Какое заимствование приемлемо», а в пункте про товары стоит уточнение «предоставленные производителем, создателем, организатором». Там же объясняется, сколько можно заимствовать: цитирование допустимо, но если «цитирование или рерайт образуют основной контент сайта», такой ресурс, по словам Яндекса, реальной ценности не несёт.
Почему страница может упасть без нарушения в Вебмастере
Страх «Яндекс банит за ИИ» возникает, когда падение позиций и санкцию принимают за одно и то же. Сам Яндекс их разделяет. Михаил Сливинский в интервью SEOnews 15 апреля 2024 года говорил так:
«Поэтому сам факт использования нейросетей не влияет на ранжирование.»
И чуть дальше:
«И в таком случае хорошие страницы живут, высоко ранжируются и органически растут, а страницы с некачественным контентом упали. Для этого не нужны санкции, и не бывает каких-то скрытых санкций.»
Там же он добавляет, что сайт опускается из-за слабого содержания, и «не важно, кем они созданы» (нейросетями или копирайтерами). Если площадка использует нейросети «со строгим контролем качества» и контент приносит пользу, Яндекс это, по его словам, «только приветствует».
У сайта могут быть две разные проблемы. Нарушение «Малополезный контент» видно в Вебмастере: у него есть описание, и его можно снять. При обычном ранжировании слабые страницы опускаются без такой отметки. Отправлять на проверку тут нечего: страница поднимется, только когда станет полезнее.
Оба сценария встречаются в одном публичном случае. Вячеслав Гришанков, владелец статейного сайта androidlime.ru, рассказал на Хабре в апреле 2025 года, как в октябре 2023 года трафик из Яндекса за одну ночь упал с 10 000 до 500 человек в сутки, а сайт получил МПК. При разборе нашлось много рекламы и около 600 дублей статей на своём же канале в Дзене. Обнаружились и дорвеи, которые воровали статьи и стояли выше первоисточника. Переписка с Яндексом длилась почти полгода. После снятия фильтра вернулось 30% трафика, но в феврале 2025 года сайт пережил второе падение, уже без отметки о нарушении в Вебмастере.
Другой случай описало агентство ITECH в SEOnews в ноябре 2023 года. Сайт лечебной косметики получил МПК 23 сентября, причём просели страницы блога, а коммерческие фильтр не задел. Причиной оказался тестовый дубль сайта, открытый для индексации. На снятие метки ушло около двух с половиной недель.
В обоих случаях фигурируют копии и дубли. Публичных разборов «сайт получил МПК именно за нейротекст» с числами мы в рунете не нашли. Это не доказывает, что таких случаев нет, но задокументированные падения, которые удалось изучить, объясняются другими причинами.
Проверить, есть ли нарушение, можно в Вебмастере: «Оптимизация сайта», затем «Безопасность и нарушения». По справке, если список нарушений там не отображается, ограничения на сайт или его разделы не действуют. Если нарушение есть, сначала нужно его исправить, затем подробно указать в описании, что изменили, поставить отметку «Нарушение исправлено» и нажать «Отправить на проверку». Во многих статьях до сих пор пишут про кнопку «Я всё исправил». В нынешней справке она называется так, как указано выше. Проверка занимает до 30 дней; повторно сообщить об исправлении можно только через 30 дней после отправки. Если нажать кнопку до устранения проблемы, придётся ждать следующей попытки.
От Баден-Бадена до ЭПОСа: как менялись требования Яндекса к текстам
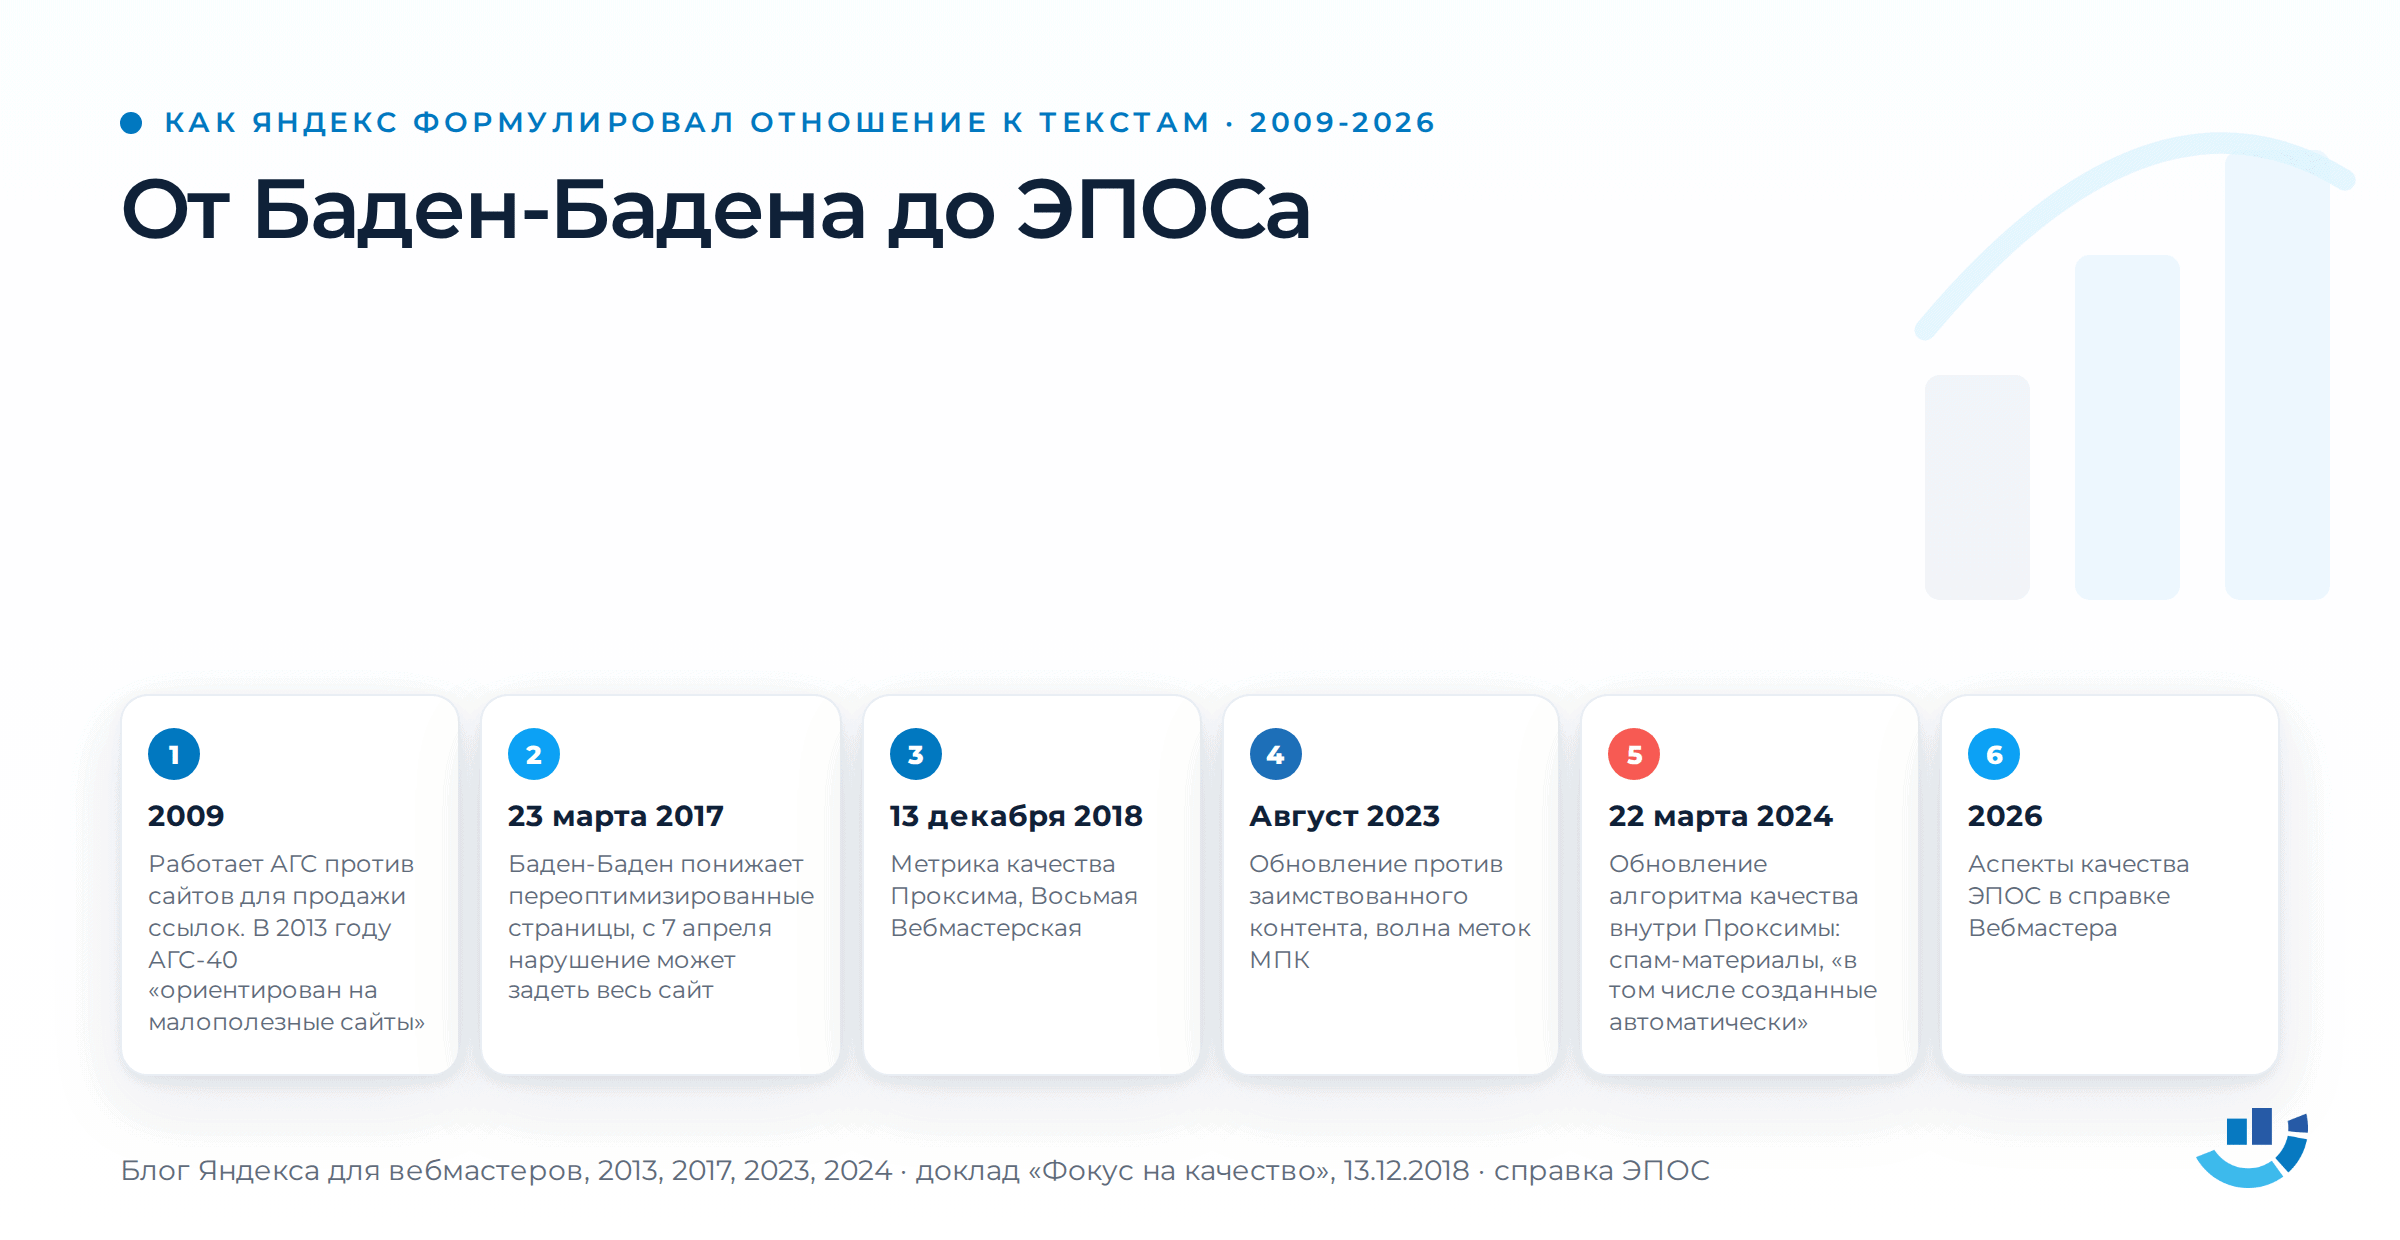
Слово «малополезные» Яндекс использовал задолго до нейросетей. В посте об алгоритме АГС-40 6 ноября 2013 года сказано, что новый классификатор «ориентирован на малополезные сайты», созданные в основном для продажи ссылок. Сам алгоритм АГС работает с 2009 года.
Алгоритм Баден-Баден Яндекс представил 23 марта 2017 года, открыв пост пародией на SEO-текст. Одна фраза из него сегодня читается иначе, чем тогда: «Мы не уверены, что такие тексты пишут люди, но совершенно очевидно, что пишутся они не для людей, а для поисковых алгоритмов». Алгоритм понижал переоптимизированные страницы. Уже 7 апреля 2017 года Яндекс объявил следующий этап: нарушение «Переоптимизация», при котором ниже могут ранжироваться все страницы сайта. Сегодня эти правила описаны в справке «Использование SEO-текстов». Она ссылается на пост 2017 года и рассматривает запросный спам и переоптимизацию отдельно от малополезного контента.
Метрику Яндекс Проксима Сливинский представил 13 декабря 2018 года на Восьмой Вебмастерской. С отметки 6:36 в записи доклада он перечисляет, что она оценивает: вероятность решения задачи пользователя и лояльность аудитории, а также баланс полезного и навязчивого. Чуть позже уточняет: метрика работает на любых типах запросов, включая некоммерческие.
В августе 2023 года Яндекс обновил алгоритмы определения заимствованного контента. По сайтам прошла волна меток МПК. Затем, 22 марта 2024 года, вышло обновление алгоритма качества, о котором мы писали в разборе контент-завода на нейросетях. В том посте Яндекс прямо описывает плохой контент: спам-материалы, «в том числе созданные автоматически», которые могут содержать бессмысленные фрагменты и «не верифицируются людьми». Алгоритм назван частью Проксимы. Сейчас в справке есть и ЭПОС с четырьмя аспектами качества; подробно он разобран в статье про SEO-продвижение в 2026 году.
Как Google относится к ИИ-контенту
Позиция Google по сути совпадает с яндексовской, хотя в деталях есть различия. В блоге Search Central 8 февраля 2023 года Google написал, что использование ИИ, в нашем переводе, «не даёт контенту особых преимуществ». К такому тексту применяют обычную оценку: хорош он или плох, зависит от пользы. Нарушением правил о спаме названа генерация «с основной целью манипулировать ранжированием». Правило scaled content abuse мы уже разбирали в статье про контент-завод.
| Вопрос | Яндекс | |
|---|---|---|
| запрещён ли ИИ-текст как таковой | нет, «сам факт использования нейросетей не влияет на ранжирование» (Сливинский) | нет, ИИ «не даёт особых преимуществ», оценивается польза |
| что под запретом | текст без анализа и редактуры с четырьмя признаками | генерация многих страниц без ценности ради позиций |
| синонимайзер и перевод | «заменили несколько слов», многократный перевод ради уникальности | «synonymizing, translating» в примерах scaled content abuse |
| маркировка ИИ | в справке про МПК не упоминается | для магазинов: сгенерированные названия и тексты карточек помечаются отдельно |
В марте 2024 года Google выпустил обновление ядра поиска и новые правила о спаме. 26 апреля компания сообщила, что низкокачественного неоригинального контента в выдаче стало на 45% меньше. Метод подсчёта Google не раскрыл. Это заявление компании о собственной работе, независимой проверки этой цифры нет.
Наказывают ли за ИИ-контент: что показали замеры
Два крупных замера по выдаче Google сходятся в выводе, но у обоих есть ограничения. Долю ИИ в текстах считал детектор, который может ошибаться. Кроме того, исследования показывают корреляцию на выборке: эксперимента с контрольной группой не было. Яндекс не изучался вовсе.
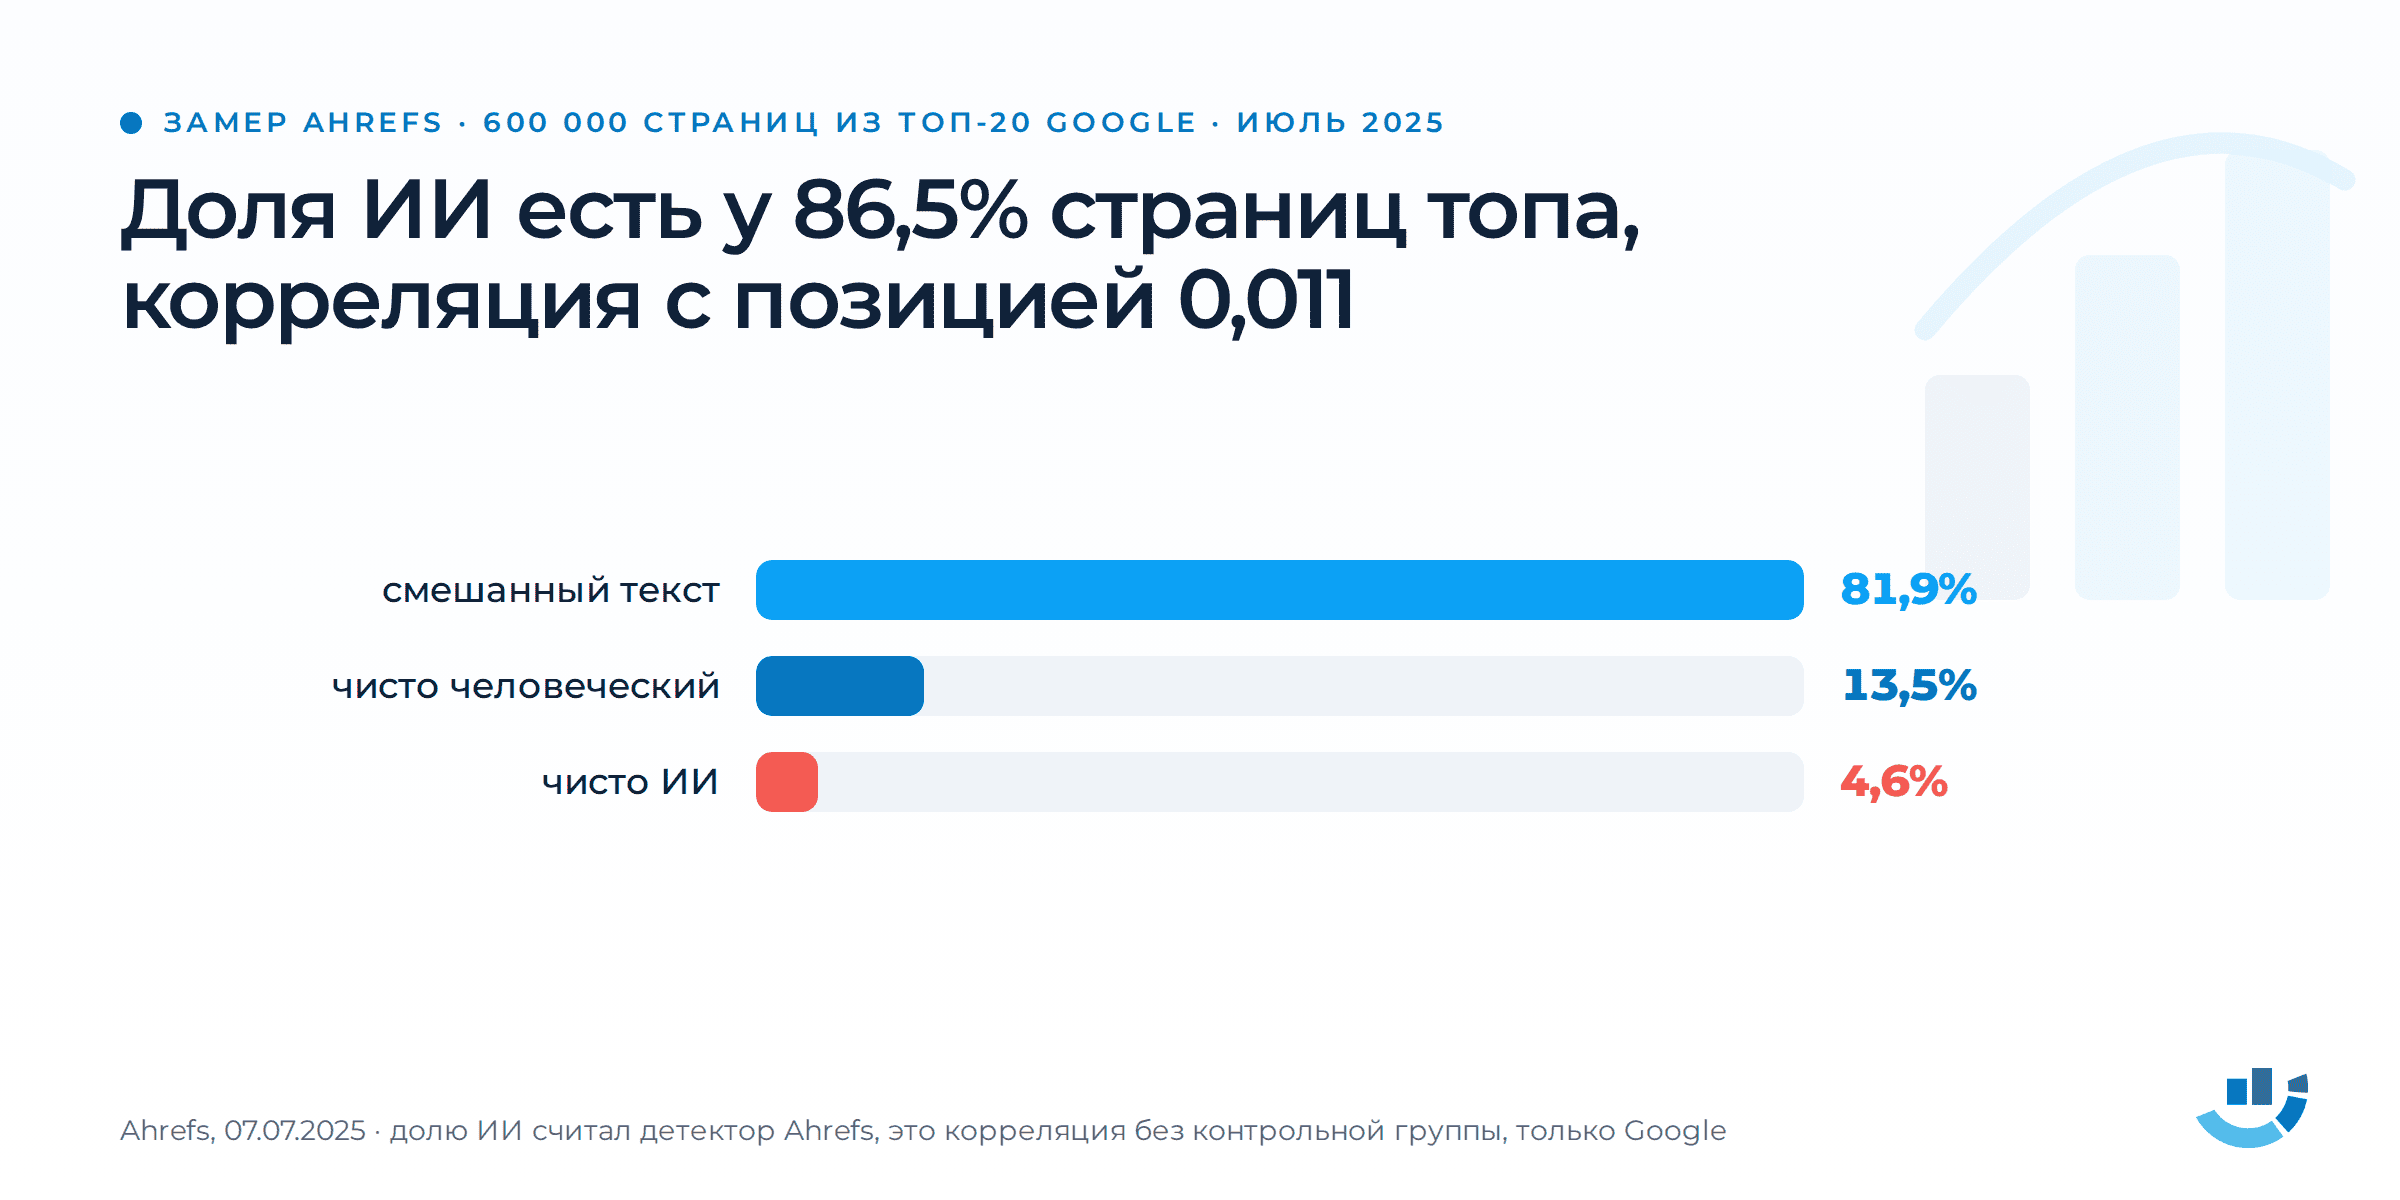
Ahrefs в июле 2025 года проверил 600 000 страниц из топ-20 по 100 000 случайных запросов своим собственным детектором. Чистым ИИ-текстом детектор счёл 4,6% страниц. На чисто человеческий пришлось 13,5%, на смешанный 81,9%. Хоть какая-то доля ИИ-текста нашлась у 86,5% страниц топа, при этом корреляция доли ИИ с позицией составила 0,011, то есть практически ноль. Авторы оговаривают: на первом месте ИИ-текста чуть меньше, а их детектор, как любой другой, даёт ложные срабатывания.
Semrush в апреле 2026 года опубликовал разбор 42 000 блог-страниц из топ-10 Google. Тексты прогнали через сторонний детектор GPTZero. Материал, который детектор отнёс к человеческому, стоял на первом месте примерно в 80% случаев, чисто машинный занимал эту позицию примерно в 9-10% случаев. То есть человек на вершине встречался в 8 раз чаще. С пятой позиции и ниже разница между ними, по словам авторов, небольшая. В той же публикации приведён опрос 224 маркетологов: 70% SEO-команд главным плюсом ИИ называют скорость, и только 19% говорят, что ИИ улучшает качество контента.
Результаты этих замеров согласуются со словами Сливинского. На первой странице выдачи машинный и человеческий текст встречаются рядом, а на самом верху чаще оказывается текст, который детектор счёл человеческим. У нас есть гипотеза, которую эти замеры не проверяли. Возможно, на первое место чаще попадает материал, где опыт автора и данные помогают точно ответить на задачу читателя; такой материал редко выпускают без участия человека. Цифры Graphite и Pew о доле машинного текста в вебе мы приводили в разборе факторов ранжирования, повторять их здесь не будем.
Как проверить свои тексты за вечер
Начните с Вебмастера и списка нарушений сайта. Если он пуст, ограничений нет. Тогда работать дальше придётся над качеством самих страниц.
Потом возьмите пять статей, которые потеряли трафик сильнее остальных. Прочитайте каждую с таблицей признаков под рукой, отмечая на полях, где текст ушёл в сторону или повторился и какие предложения можно вычеркнуть без потери смысла. Проверьте также, где рассуждение пересказывает заголовок и какие факты стоят без источника. Если пометок больше, чем абзацев, статью проще переписать под задачу читателя, чем чистить.
Отдельно проверьте дубли. Копии обнаружились в обоих публичных случаях МПК, которые мы разобрали, причём у косметического сайта причиной прямо назван тестовый дубль, открытый для робота. У статейного сайта ситуация сложнее: владелец нашёл дубли на Дзене и чужие копии своих статей, к тому же на сайте было много рекламы. Какая из причин сработала, Яндекс ему не сообщал. При этом свои тексты на других площадках справка малополезными не считает.
Если тексты для сайта вы уже генерируете, проверьте, кто редактирует их перед публикацией и сверяет факты. Как устроен такой конвейер у нас и сколько времени уходит на проверку каждого числа, мы описали в статье о контент-заводе на нейросетях. Сами инструменты для генерации собраны в обзоре функций ИИ в маркетинге. О том, что в тексте по-прежнему может дать только человек, мы писали в материале про сайт в эпоху ИИ.
Частые вопросы
Банит ли Яндекс за тексты, написанные нейросетью?
Отдельной санкции за нейросети нет. Представитель Поиска Яндекса говорил, что сам факт использования нейросетей на ранжирование не влияет. Нарушение «Малополезный контент» ставят за результат: например, за копирование или текст без редактуры с признаками из справки. Автоматические каталоги тоже входят в список нарушений.
Как понять, что сайт попал под МПК?
Открыть в Вебмастере «Оптимизация сайта», затем «Безопасность и нарушения». Пустой список означает, что ограничений нет, хотя трафик при этом может падать из-за обычного ранжирования. По словам Сливинского, слабые страницы опускаются без всяких скрытых санкций.
Сколько ждать после исправления?
По справке Вебмастера проверка идёт до 30 дней. Повторно отправить сайт можно только через 30 дней. В блоге 2023 года Яндекс писал, что ограничения обычно снимаются в течение месяца после устранения проблемы.
Можно ли генерировать описания товаров нейросетью?
В справке такого разрешения нет. Список «Какой контент не признается малополезным» касается заимствования: текст производителя о своём товаре можно разместить у себя, и копированием это не сочтут. Сгенерированное описание проверяется по тем же признакам, что и любой другой текст.
Нужно ли помечать ИИ-контент на сайте?
В справке Яндекса о малополезном контенте такого требования нет. Google для магазинов требует отдельно помечать сгенерированные названия и описания в карточках, а сгенерированные картинки снабжать специальными метаданными.
Что такое алгоритм Баден-Баден?
Алгоритм Яндекса против переоптимизированных текстов, объявленный 23 марта 2017 года. Сначала он понижал страницы, написанные для робота; с апреля 2017 года нарушение мог получить весь сайт. Сегодня эти правила описаны в справке «Использование SEO-текстов».
Что такое Яндекс Проксима?
Метрика качества страниц, которую Яндекс представил в декабре 2018 года. Она строится на оценках асессоров и дополнительных сигналах. Метрика учитывает, решает ли страница задачу пользователя и насколько полезен и оригинален контент, а также как соотносится полезное с навязчивым. Обновление 2024 года против слабых текстов работает на её основе.
Проверим тексты вашего сайта по признакам малополезного контента. Optimism разбирает статьи по справке Яндекса и говорит прямо, какие стоит переписать или объединить. Отдельно укажем тексты, которые можно оставить как есть, и проверим раздел нарушений в Вебмастере. Обсудить аудит текстов.
Источники
Яндекс
- Яндекс Вебмастер, справка «Малополезный контент», по состоянию на сентябрь 2026
- Яндекс Вебмастер, справка о проверке сайта после исправления нарушений, 2026
- Блог Яндекса для вебмастеров, «Яндекс обновил алгоритмы поиска, чтобы лучше определять неоригинальный контент», 29 августа 2023
- Блог Яндекса для вебмастеров, «Малополезный контент: почему может быть обнаружено такое нарушение», 5 октября 2023
- Михаил Сливинский, интервью SEOnews об алгоритмах качества и сгенерированных текстах, 15 апреля 2024
- Блог Яндекса для вебмастеров, «Баден-Баден – новый алгоритм определения переоптимизированных текстов», 23 марта 2017, и «Баден-Баден и нарушения на сайте», 7 апреля 2017
- Яндекс, справка «Как измеряется и улучшается качество Поиска», 2024
- Google Search Central, «Google Search’s guidance about AI-generated content», 8 февраля 2023
- Google, «New ways we’re tackling spammy, low-quality content on Search», март 2024, обновлено 26 апреля 2024
- Google Search Central, «Google Search’s guidance on using generative AI content on your website», 2025
Замеры и случаи
- Ahrefs, «AI-Generated Content Does Not Hurt Your Google Rankings (600,000 Pages Analyzed)», июль 2025
- Semrush, «Does AI content rank well in search?», апрель 2026
- Вячеслав Гришанков, Хабр, «Как я пытаюсь восстановить трафик сайта после падения на 90%», апрель 2025
- ITECH, SEOnews, «Как вывести сайт из-под МПК фильтра Яндекса. Кейс», ноябрь 2023
Теги публикации: ИИ-контент, качество контента, малополезный контент, нейросети, Проксима, Яндекс Вебмастер


Такой подход позволяет увеличить спрос и снизить стоимость каждого клиента
Продвижение с оплатой за трафик
Оптимизация сайта под максимально широкий пул ключевых запросов
Вид поискового продвижения, при котором оплата производится за целевые действия
