Семантическое ядро: как собрать и не утонуть в таблице на тысячи строк

Семантическое ядро полезно тогда, когда из него получается список страниц, которые компания должна сделать, с порядком работ по ним. Таблица на десять тысяч фраз этого не даёт. По справке Яндекса похожие страницы «отвечают на один и тот же запрос пользователя, поэтому алгоритм оставляет в поиске только одну», а по замеру Ahrefs страница на первом месте собирает ещё сотни запросов. Ниже разберём, с чего начинать сбор и какие фразы выбрасывать сразу. Затем сгруппируем остальное и посмотрим, как через три месяца понять, что ядро работает.
Ядро на тысячи фраз, которое никто не открыл
Подрядчик сдаёт файл: несколько тысяч строк с частотностью и цветными группами. В договоре стоит галочка «ядро собрано». Через полгода выясняется, что по файлу не появилось ни одной новой страницы, потому что никто не понял, какую делать первой.
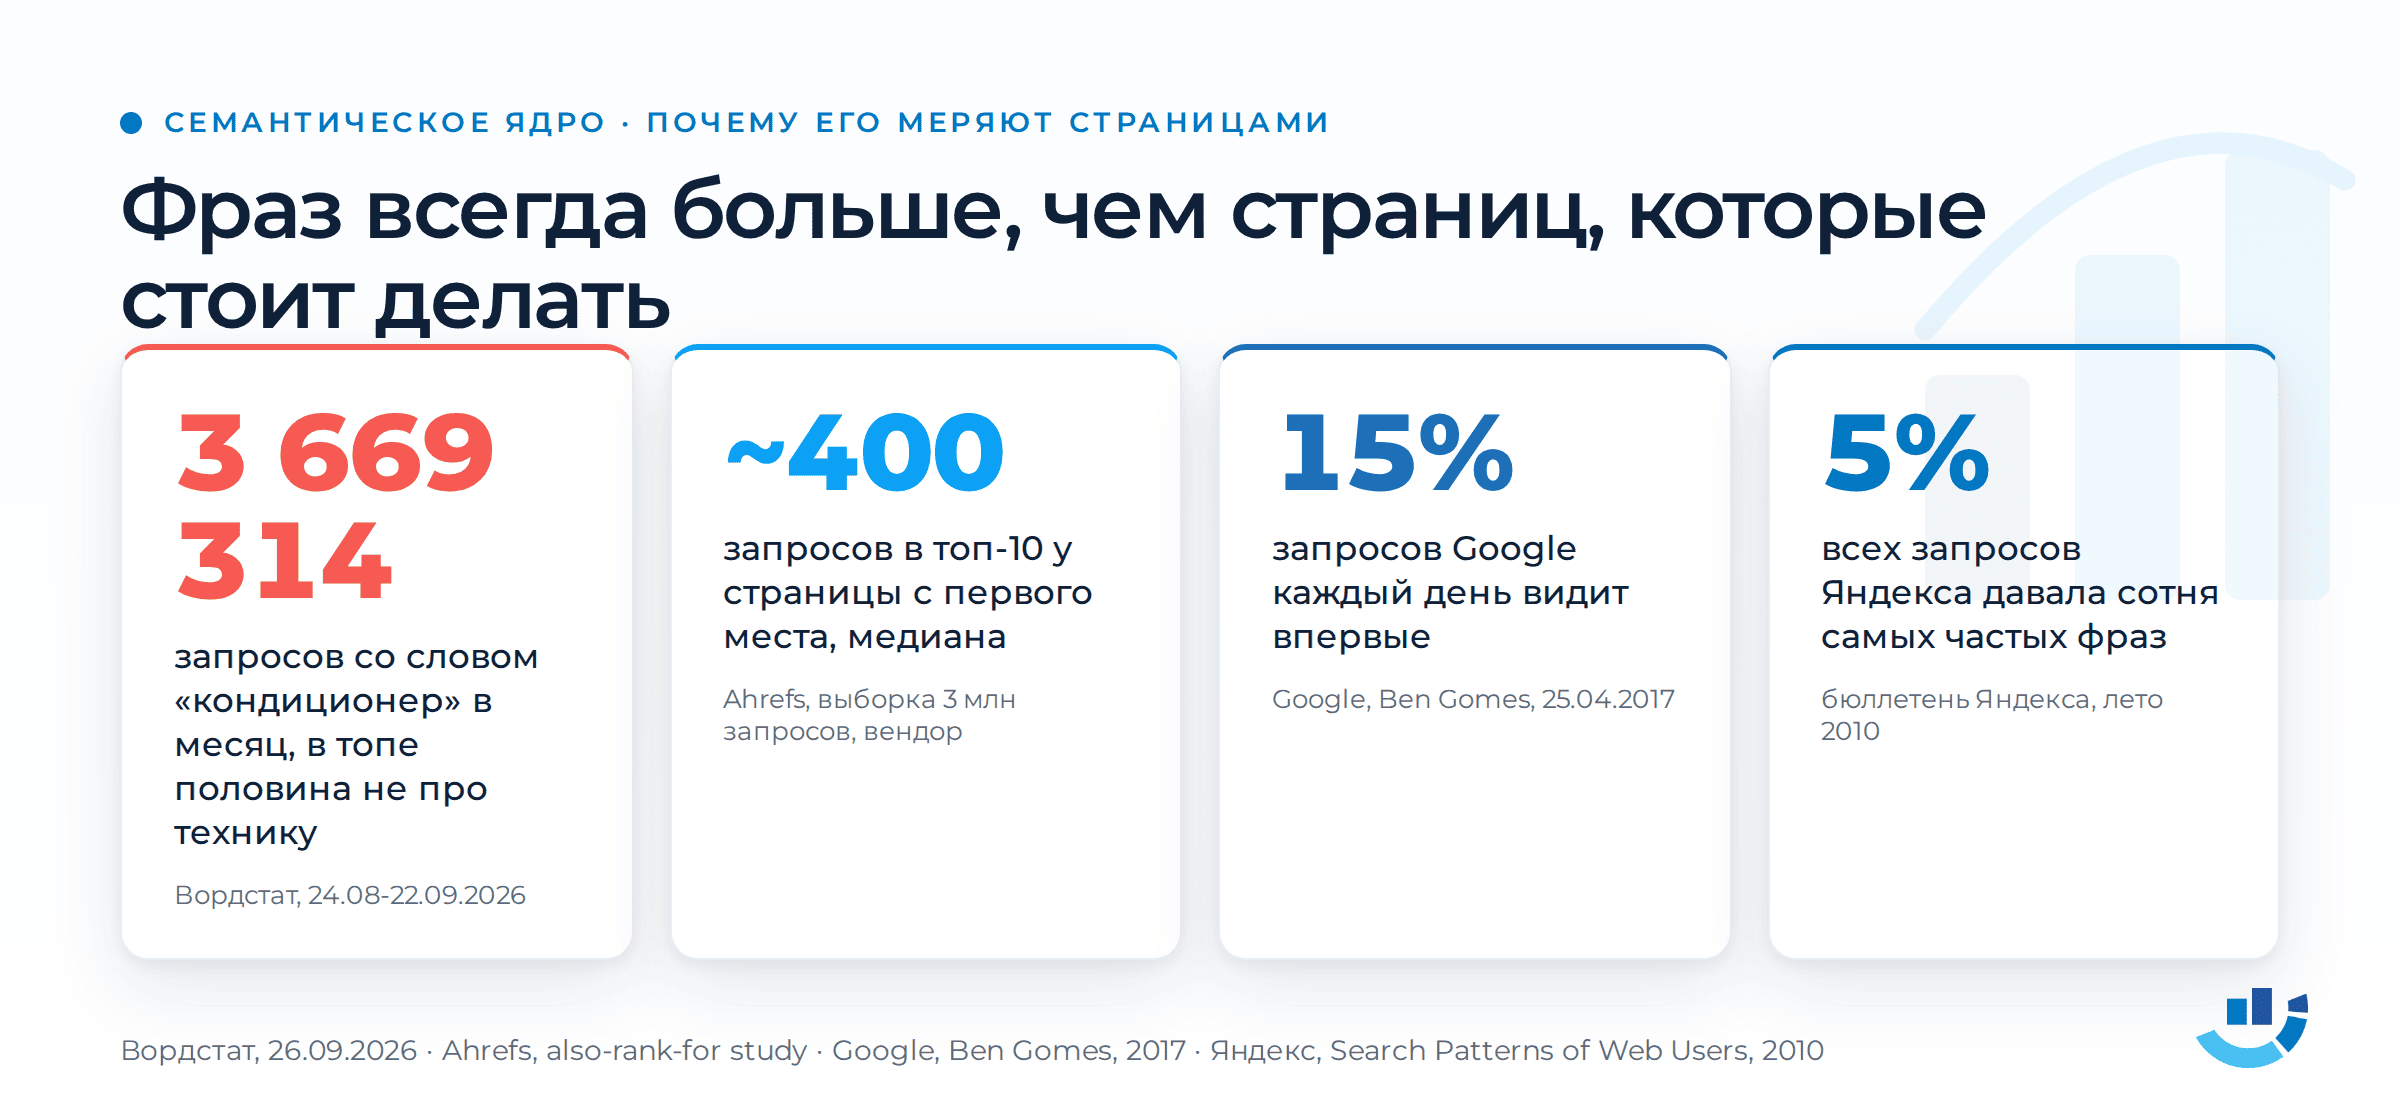
Объём сам по себе не виноват. Длинный хвост запросов огромен: в базе Ahrefs по США почти 93% всех фраз ищут десять раз в месяц и реже. Яндекс ещё в 2010 году подсчитал, что сотня самых частых запросов даёт лишь 5% всего потока. Собрать всё невозможно, да и такая задача ядру не нужна. Оно помогает решить, какие из этих фраз заслуживают страницы.
Состояние ядра можно проверить по симптомам. Дата, когда вам сдали файл, мало о нём говорит.
- В файле нет колонки со страницей: фразы сгруппированы, но адрес, которому принадлежит группа, нигде не указан.
- В Вебмастере, в мониторинге запросов, под одной фразой всплывают разные адреса вашего сайта. Яндекс там показывает самый частый по показам URL для каждого запроса, так что прыгающий адрес виден без сторонних сервисов.
- Страницы, сделанные по ядру, вылетают из поиска со статусом «малоценная или маловостребованная».
- В поиске по сайту и в отчёте Директа люди ищут то, чего в ядре нет вовсе.
- Сезонную страницу публикуют в разгар сезона, хотя спрос начал расти за несколько месяцев до пика.
- Частотность в файле посчитана широкой формой, без кавычек.
Если совпали два пункта из шести, я бы пересобирал ядро, даже когда его сдали месяц назад.
Как собрать семантическое ядро, если начать со списка денег
Сбор семантического ядра удобнее начинать с листа бумаги. Вордстат подождёт. Выпишите услуги и товары, которые вы действительно продаёте, и отметьте, какие из них приносят маржу и на какие хватает мощностей. Если монтаж кондиционеров расписан на два месяца вперёд, страницу под него можно отложить, а чистку сплит-систем с хорошей наценкой взять в работу раньше.
Этот список станет фильтром ещё до парсинга. Всё, что не ведёт к позиции из него, можно не собирать или вынести в отдельный файл для блога. Ядро сразу получится в разы короче: в нём останутся фразы, по которым вам есть что предложить.
Как это выглядит в интерфейсе Вебмастера, показывает Михаил Сливинский во второй серии роликов Яндекса «Как работать со спросом в поиске Яндекса». На примере магазина моющих пылесосов он оставляет в списке целевые фразы, убирая стоп-словами то, под что у магазина нет посадочной. Ролик длится четыре минуты, и за это время можно увидеть, как устроен отсев.
Пять источников фраз и чего нет в каждом
У каждого источника есть слепая зона, поэтому ядро из одного Вордстата получается однобоким.
- Вордстат показывает статистику запросов к Яндексу. По справке он считает фразу «с учетом всех возможных форм» и поддерживает операторы («!», кавычки, квадратные скобки, минус). Историю по месяцам сервис хранит с января 2018 года. Есть ли у вас ответ на запрос, по этим данным не узнать.
- В поисковых подсказках можно найти живые формулировки, которые люди набирают прямо сейчас. Частотности в них нет, её придётся проверять отдельно.
- Отчёт Директа «Поисковые запросы» хранит данные за последние 180 дней и делит запросы на целевые, альтернативные, сопутствующие, с упоминанием конкурентов и широкие. Такое деление удобно для отсева, но в отчёт попадает лишь то, по чему уже шла реклама.
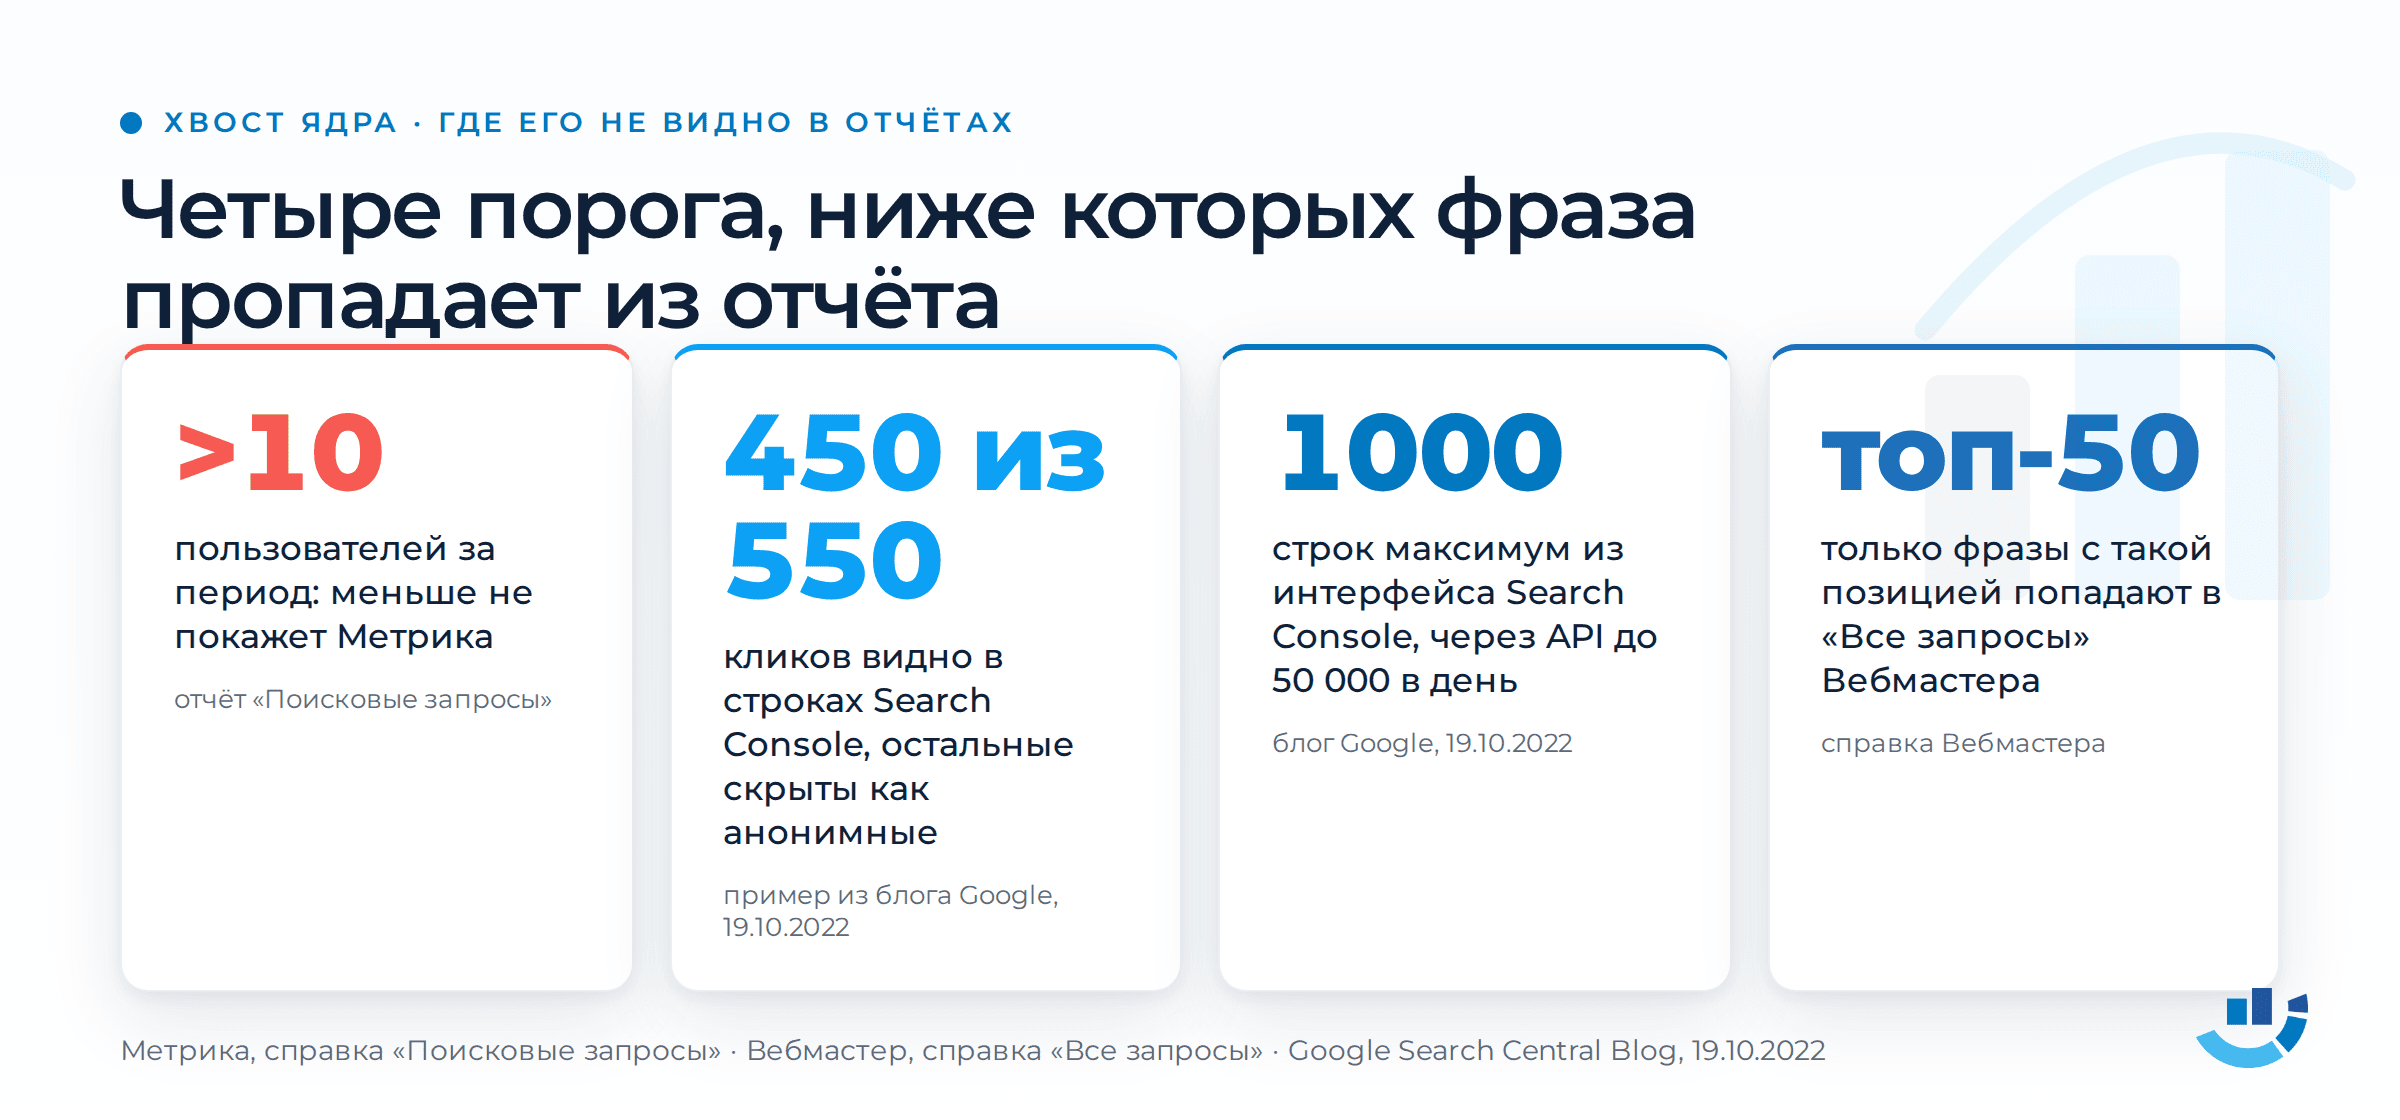
- Поиск по сайту и Метрика показывают, что люди не нашли у вас с первого раза. Метрика сама распознаёт параметры q, text, query и search в адресе. В её отчёте «Поисковые запросы» видны только фразы, по которым перешло более 10 пользователей за период. Хвост ниже этого порога в отчёт не попадёт.
- Search Console даёт данные по Google, а выдача конкурентов позволяет изучить чужой опыт. Google не включает в таблицы анонимизированные запросы: в примере из блога Google строки дают 450 кликов при итоге 550. Из интерфейса выгружается не больше 1000 строк, через API до 50 000 в день.
Отдельно стоит инструмент Вебмастера «Подбор поисковых запросов и анализ рынка». В нём есть данные о спросе, кликах и конкурентности. Сервис сам группирует запросы, «которые близки по смыслу или по интенту», а первым делом предлагает поле «Слова-минус» с примерами «опт», «б/у», «инструкции»: работу со списком Яндекс предлагает начать с отсева.
Частотность, которая врёт
Число из Вордстата без операторов складывает все запросы, где слово встречается в любой форме и с любыми соседями. Для страницы оно почти ничего не значит. Пример есть прямо в справке Директа: запрос «ремонт» набирает 12 миллионов показов в месяц, но за этой цифрой могут стоять и квартиры, и машины, и телефоны.
Кавычки фиксируют количество слов. Чтобы закрепить форму слова, нужен восклицательный знак, а порядок задают квадратные скобки. Если в файле подрядчика нет пометки, какая частотность посчитана, считайте, что широкая. Совет ставить плюс перед предлогом уже устарел: по справке Вордстат теперь сам фиксирует стоп-слова.
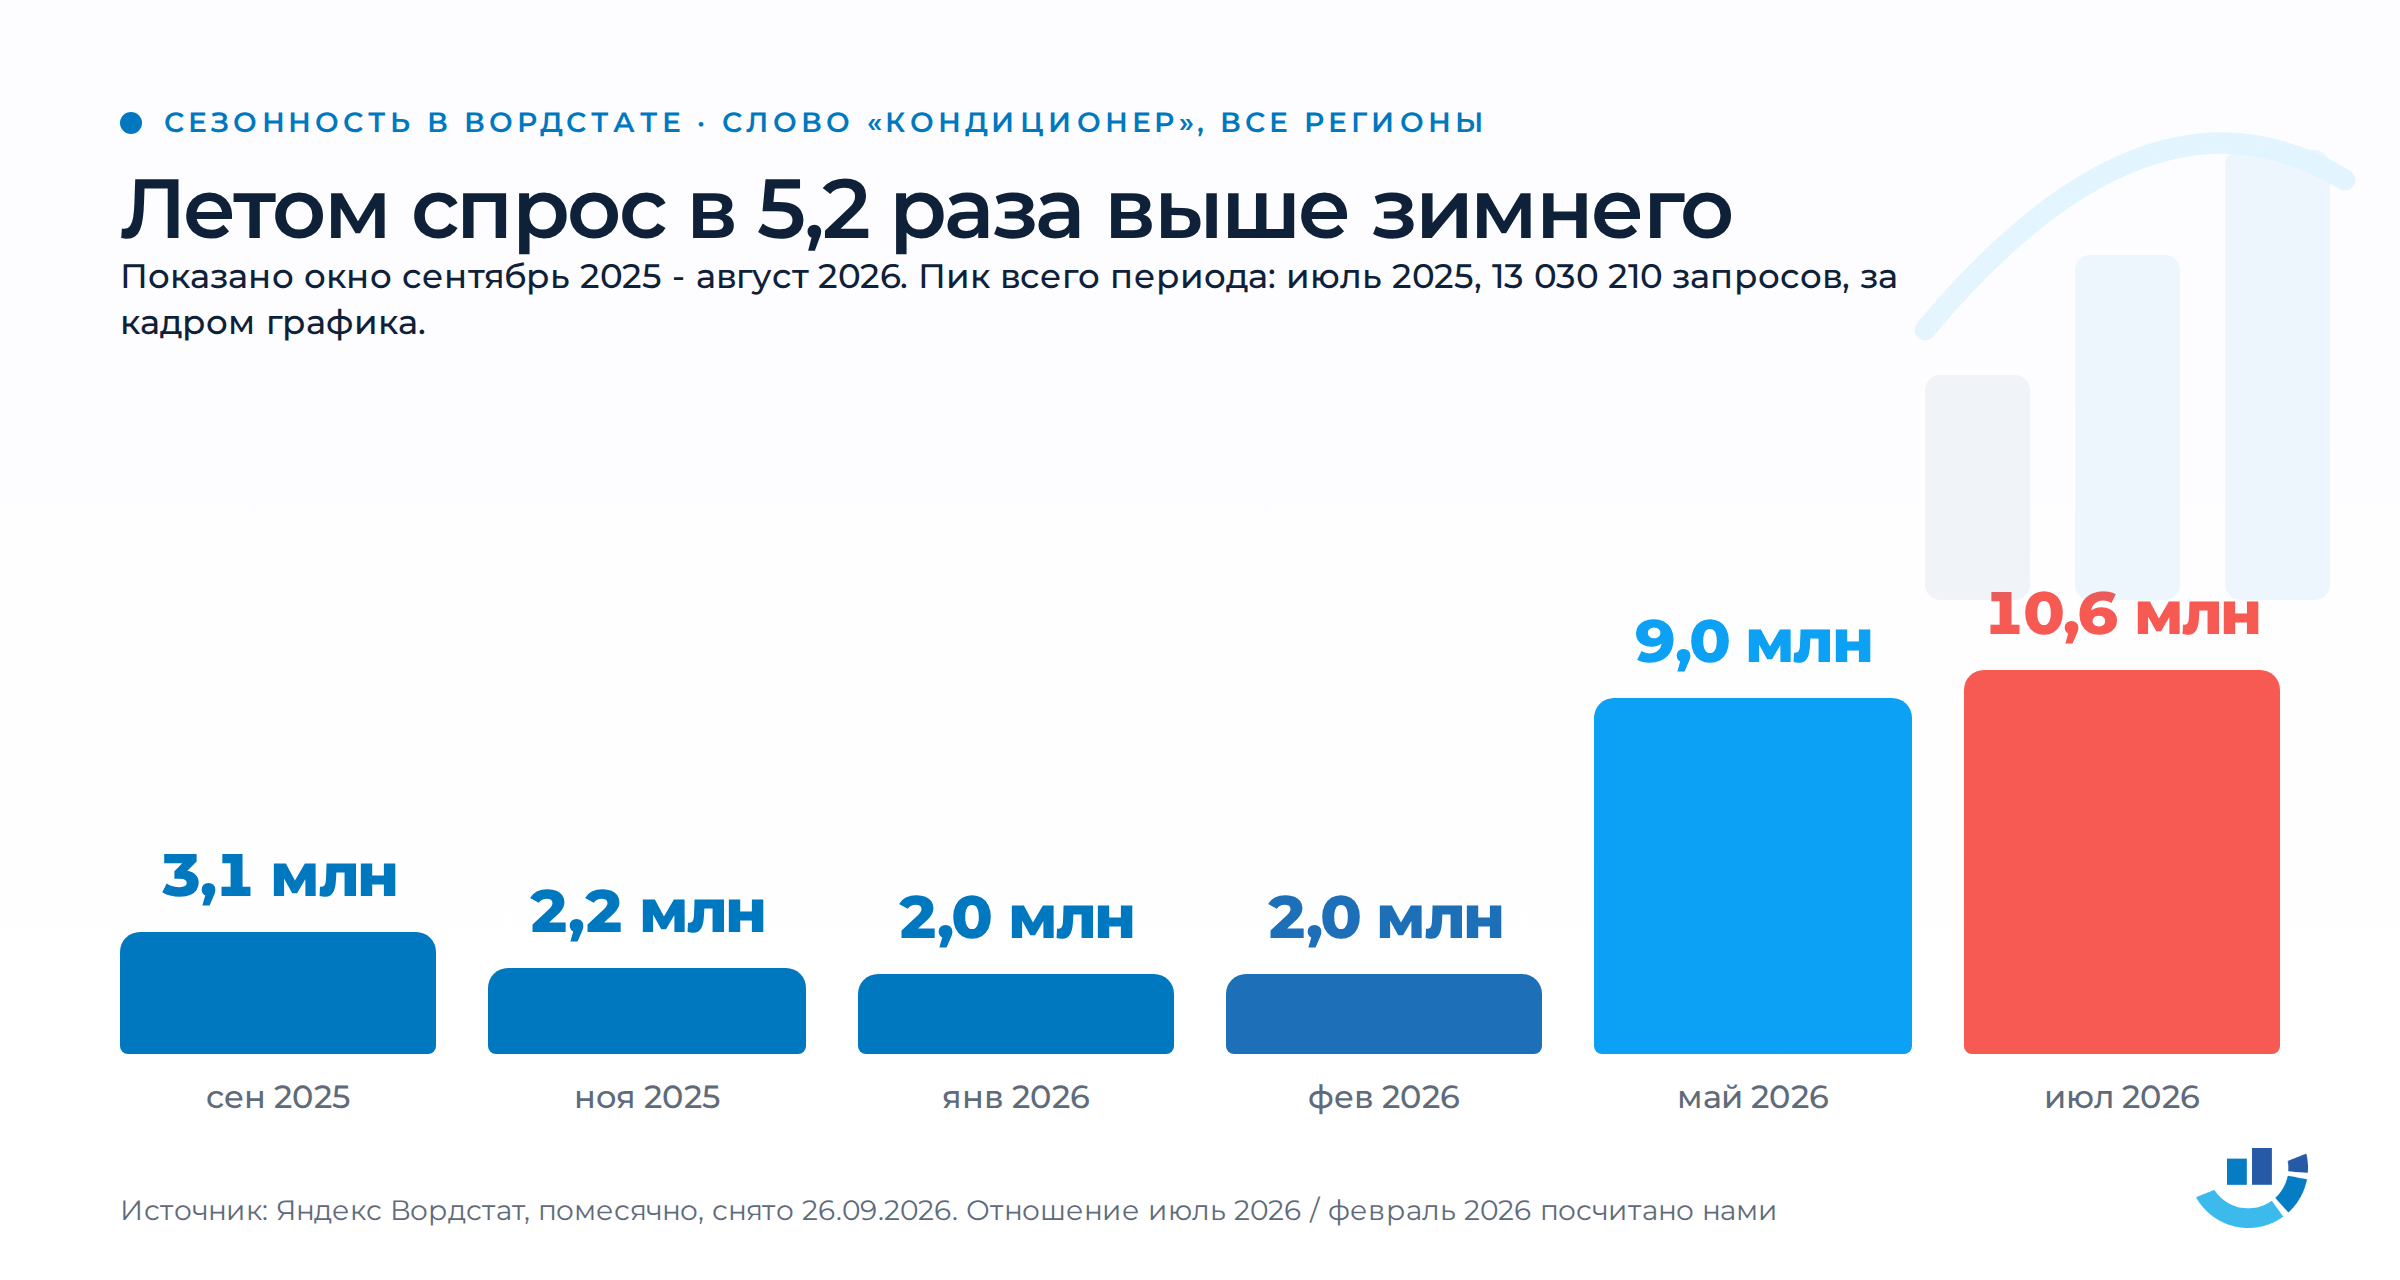
Дальше проверьте регион и сезон. Вордстат показывает распределение по регионам за последние 30 дней, и для компании, работающей в одном городе, общероссийская цифра бесполезна. Сезон тоже меняет картину. По слову «кондиционер» в июле 2025 года было 13 030 210 запросов, в феврале 2026 года 2 038 269. Разница в 6,4 раза. Тот, кто собирал ядро зимой, увидел спрос в несколько раз меньше летнего и мог поставить эту страницу в конец очереди.
Наконец, рядом может оказаться чужой интент. В топе Вордстата по тому же «кондиционеру» за месяц с 24.08.2026 по 22.09.2026 стоят «кондиционер для белья» (153 356), «ремень кондиционера» (147 928), «кондиционер для волос» (96 485), «кондиционер приора» (64 653). За одним словом стоят три разных рынка. Вместе с климатической техникой в выгрузку попадают автозапчасти и товары с полки бытовой химии, и без чистки всё это останется в одной таблице.
Три причины выбросить запрос сразу
Большую часть файла можно отсеять тремя вопросами. Владелец бизнеса обычно отвечает на каждый быстрее подрядчика.
Первый вопрос касается намерения. Человек с запросом «как выбрать кондиционер» хочет разобраться; тот, кто пишет «купить кондиционер», готов к покупке. Информационный запрос в группе коммерческой страницы тянет её в сторону статьи, из-за чего она хуже отвечает обоим. Такие фразы уходят в отдельный файл для блога или справочного раздела.
Затем проверьте, нет ли в запросе чужого бренда или товара. Название конкурента либо модели, которой у вас нет, приведёт трафик, который не превратится в заявку. В Директе для таких запросов предусмотрена отдельная категория.
Третий вопрос: есть ли у вас ответ. В справке Яндекса нерелевантный запрос определён так: это запрос, по которому «страница сайта не дает ожидаемого ответа», а её содержимое «не соответствует теме, цели или формату запроса пользователя». Если по фразе вам нечего сказать, страница под неё проиграет. Яндекс прямо просит не привлекать людей по таким запросам.
При сомнениях проверьте выдачу. Если в топе по фразе стоят энциклопедии и обзоры, а вы продаёте услугу, фраза уходит из коммерческого ядра при любой частотности.
Кластеризация запросов без магии
Кластеризация семантического ядра почти во всех сервисах устроена одинаково. Для каждой пары фраз берут первую десятку выдачи и считают, сколько адресов в ней совпадает. Если совпадений больше порога, фразы кладут в одну группу. Поисковик уже показывает по ним одни и те же страницы, то есть считает их одним вопросом. Semrush в своём руководстве предлагает тот же критерий: если одни и те же страницы хорошо ранжируются по обеим фразам, их стоит объединить.
Порог каждый вендор выбирает сам, поисковик такой нормы не задаёт. Rush Analytics советует точность 5 для большинства тематик, 3 или 4 для информационных сайтов и 6 или 7 для очень конкурентных. У KeyAssort минимальная сила группировки 2, 3 или 4 в зависимости от метода, у SearchLab для интернет-магазинов «от 5 общих страниц в топ-10». С названиями методов тоже легко запутаться. Soft у Топвизора и Rush означает «все фразы сравниваются с самой частотной», а у KeyAssort так называется цепочка, где крайние фразы могут вообще не иметь общих адресов. Прежде чем спорить с подрядчиком о «софте», уточните, в каком сервисе он собран.
Автоматика ошибается в предсказуемых местах. При просмотре групп эти ошибки можно заметить без дополнительных инструментов.
- В одной группе оказываются соседние интенты. SearchLab сам пишет, что мягкая группировка «нередко объединяет в одну группу запросы, для которых было бы лучше подобрать разные целевые страницы».
- Файл распадается на сотни мелких групп по две-три фразы: жёсткий метод, по словам самих сервисов, иногда упускает возможность объединить похожие запросы.
- Часть фраз остаётся без группы. Обычно это хвост, по которому в выдаче мало совпадений; его дособирают руками или оставляют на потом.
На ручную досборку уходит меньше времени, чем кажется. Откройте группы с самой большой суммарной частотностью и прочтите фразы вслух, прикидывая, ответит ли на них одна страница. Semrush советует объединять фразы, если отдельные страницы получатся слишком тонкими. Если же общая страница выйдет слишком широкой, группу стоит разделить.
Из групп в структуру сайта
Каждая группа после проверки превращается в одну страницу. Справка Вебмастера объясняет, почему вторая не нужна: «похожие страницы отвечают на один и тот же запрос пользователя, поэтому алгоритм оставляет в поиске только одну». Там же сказано, что квот на число страниц у Яндекса нет. Но увеличение их количества ничего не даёт, если страницы конкурируют между собой.
Модель «одна фраза, одна страница» опровергают и данные Ahrefs. По выборке из трёх миллионов запросов страница на первом месте ранжируется в топ-10 ещё почти по 1000 запросов, медиана около 400. Semrush приводит пример хвоста, где отдельные фразы набирают по 30 показов в месяц, а группа целиком 980. Одна хорошая страница собирает такой хвост сама. Создание тонкой страницы под каждую фразу обернётся проблемами с индексацией.
Группу, под которую страницы пока нет, запишите в очередь с пометкой «создать». Заглушка ей не нужна: пустая страница без содержания рискует получить тот самый статус маловостребованной.
В четвёртой серии тех же роликов Сливинский разбирает две крайности. Одна возникает, когда под каждый запрос делают страницу: сигналы размазываются, и страницы то появляются в поиске, то пропадают. Другая крайность возникает там, где спрос есть, но посадочную под него так и не создали.
Очередь страниц: что делать первым
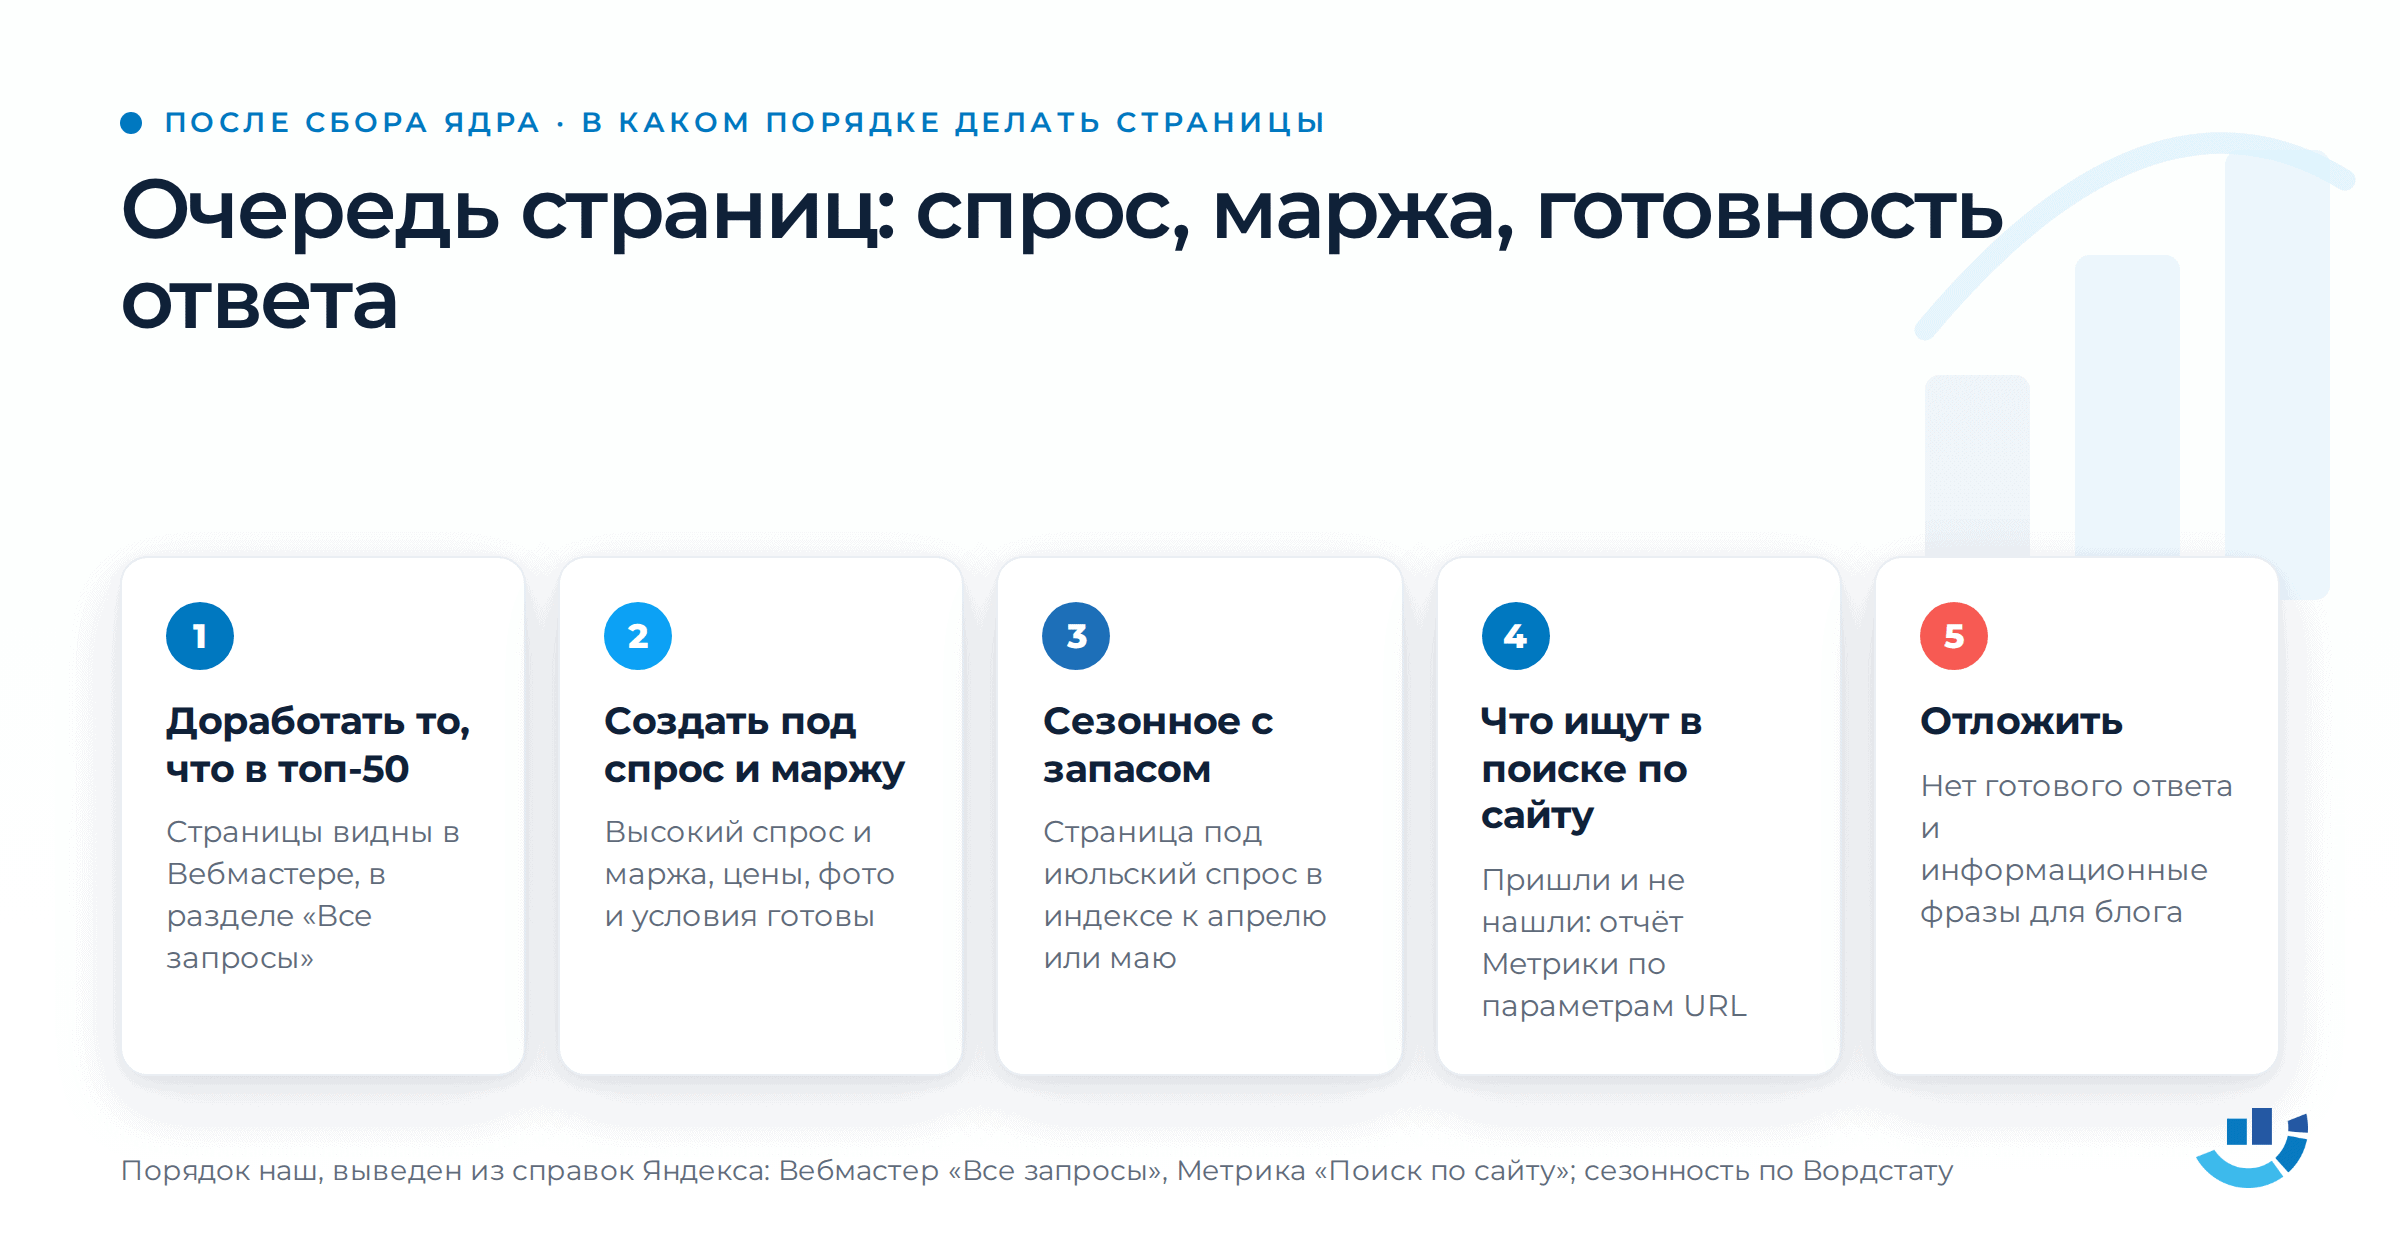
Ни одна из десяти ведущих страниц выдачи по запросу «семантическое ядро» не объясняет, в каком порядке делать сами страницы. Предлагаю использовать для этого данные ядра. Каждой группе ставим три оценки. Первые две: спрос в вашем регионе и маржа услуги из списка денег. Третья показывает готовность ответа: есть ли у вас цены, фото, условия и специалист, который проверит текст.
- Сначала доработайте страницы, которые уже стоят в топ-50 по своей группе. Они видны в Вебмастере в разделе «Все запросы», и поднять их дешевле, чем построить новые.
- Затем берите новые страницы под группы с высоким спросом и высокой маржой, где ответ готов.
- Сезонные группы идут следом, с запасом по времени. Страница под июльский спрос на кондиционеры должна быть в индексе к апрелю или маю, раньше роста запросов.
- После них переходите к группам из поиска по сайту: люди уже пришли к вам и не нашли нужного.
- В конце очереди останутся группы, где ответ пока не готов, и информационные фразы для блога.
Когда очередь готова и подрядчик прислал конкретные страницы, их удобно проверить по отдельному списку вопросов: мы разобрали его в статье о структуре сайта и приоритете страниц. Там же описаны четыре решения по каждой строке и каннибализация, поэтому здесь я на них не останавливаюсь.
Что положить в ТЗ копирайтеру
Задание по ядру удобно собирать таблицей, где одна строка соответствует одной странице. Шаблон ниже можно скопировать в свою электронную таблицу.
| Страница | Основная фраза | Группа | Интент | Что уже стоит в топе | Объём |
|---|---|---|---|---|---|
| адрес или «создать» | самая частотная фраза группы в кавычках | все фразы группы через запятую | купить, заказать, узнать цену, разобраться | тип страниц в первой десятке: каталоги, услуги, статьи, форумы | по задаче страницы, с ориентиром на топ |
| /chistka-kondicionerov/ | «чистка кондиционера» | чистка сплит-системы, чистка кондиционера цена, почистить кондиционер дома | заказать услугу | страницы услуг с ценой и формой заявки | прайс, этапы работ, частые вопросы |
С последней колонкой легко ошибиться. Google в рекомендациях о полезном контенте прямо называет проблемой тексты «определенной длины, поскольку слышали или читали, что Google считает ее оптимальной», и добавляет в скобках: «Это не так». Контролируемые тесты SearchPilot показывают, насколько результат зависит от сайта. У клиента из туризма удаление SEO-текста с категорий уронило органический трафик на 3,8%, а у интернет-магазина в 2024 году такое же удаление дало статистически значимый рост на мобильных. Приём один, но результаты у двух клиентов получились с разным знаком, поэтому объём задавайте исходя из задачи страницы и проверяйте на своих данных.
Как через три месяца понять, что ядро рабочее
Для проверки хватает трёх замеров в бесплатных сервисах Яндекса. Начните с индекса: все страницы из очереди должны быть в поиске, без статуса малоценной. Затем посмотрите, какая доля фраз каждой группы вошла в топ-30. Если группа за три месяца не сдвинулась, обычно она собрана неверно или страница не отвечает на её вопрос. Больше всего о результате скажут заявки. Цели Метрики по страницам входа покажут, какие группы приносят обращения, а какие дают только трафик.
Когда ядро уже год в работе и вопрос стоит не о сборке, а о ревизии, пригодится наш старый разбор аудита семантического ядра: там девять проверок готового ядра, от пустых запросов до групп, собранных неверно.
Пересобирать ядро целиком каждый квартал не нужно, дополнять стоит постоянно. Google с 2017 года повторяет, что 15% запросов, которые он видит за день, раньше не встречались. Поиск по сайту и отчёт Директа приносят новые фразы; ещё один источник пополнения, поисковые подсказки. Раз в месяц эти фразы раскладывают по существующим группам или ставят в очередь новой строкой. Что добавить в отчёт подрядчика, чтобы видеть эти цифры, разобрано в статье о SEO-продвижении в 2026 году.
Что показали чужие чистки ядра и сайта
Публичных кейсов про отсев немного, и доказательность у них разная.
Самые убедительные данные у SearchPilot: два контролируемых теста с группами страниц, о которых шла речь выше. У одного клиента органика упала на 3,8% (по оценке авторов, около 9 800 сессий в месяц), у другого вырос трафик на мобильных.
HubSpot сравнивал показатели до и после, без контрольной группы. Компания проверила 4000 самых старых адресов блога: 951 признали перспективными, 2888 рекомендовали убрать. Сама чистка, по признанию команды, ожидаемого прироста трафика не дала. Зато 76 обновлённых постов через полгода набрали на 458% больше трафика. Их отбирали по наибольшему спросу, так что часть роста заложена самим отбором. Даже компании такого размера понадобилась очередь: за весь 2024 год команда успела обновить только 240 постов.
В статье на Хабре владелец магазина запчастей для спецтехники тоже сравнивает показатели до и после. Скоринг отобрал 65 000 карточек, почти 12% каталога, на которые приходилось 6% трафика. После удаления недельный трафик вырос примерно с 3200 до 3550. Автор сам предупреждает: дальше изолированный эффект посмотреть не удастся из-за других работ на сайте. Взятые вместе, три истории показывают, как отсев освобождает силы для доработки оставшихся страниц, с которой и приходит прибавка трафика.
Частые вопросы
Сколько запросов должно быть в семантическом ядре?
Общего числа нет. Исследований с таким ориентиром мы не нашли ни у Ahrefs, ни у Semrush; нет его и в документации российских сервисов. Ядро меряют страницами: сколько групп прошло отсев и сколько из них вы готовы сделать за ближайший квартал.
Можно ли собрать семантическое ядро сайта самому?
Да, для небольшого сайта хватит Вордстата, Вебмастера и Метрики. Подбор запросов в Вебмастере сам группирует фразы и предлагает минус-слова. Больше всего затруднений вызывает отсев, поэтому его лучше поручить тому, кто знает маржу и возможности компании.
Чем отличается широкая частотность от частотности в кавычках?
Широкая считает все запросы, где встречается фраза, в любых формах и с любыми словами рядом. Кавычки убирают дополнительные слова; если нужно зафиксировать ещё и форму, добавляют восклицательный знак. Для решения о странице нужна узкая цифра по вашему региону.
Как часто обновлять ядро?
Ориентируйтесь на симптомы. Проверьте ядро, если под одной фразой прыгают адреса или страницы получают статус маловостребованных. Новые запросы в поиске по сайту тоже повод вернуться к файлу. Дополнять очередь новыми фразами удобно раз в месяц.
Что делать, если две страницы сайта борются за один запрос?
Сравните их и выберите, какую оставить. Вторую можно объединить с ней или переписать под другую группу. Яндекс называет это конкуренцией между собой и в поиске всё равно оставит одну из них.
Соберём ядро как очередь страниц. Optimism отсеет запросы с учётом вашей маржи и сгруппирует их по выдаче. Затем расставим группы в очередь по приоритетам, чтобы было понятно, какие страницы делать первыми. На каждую страницу вы получите ТЗ по шаблону из этой статьи. Обсудить SEO-продвижение.
Источники
Справки Яндекса
- Вордстат: что показывает сервис
- Вордстат: вкладки Динамика, Регионы, Топы запросов
- Вордстат: операторы
- Вордстат: стоп-слова
- Директ: подбор слов и пример с запросом «ремонт»
- Директ: отчёт «Поисковые запросы»
- Вебмастер: все запросы и группы
- Вебмастер: мониторинг запросов
- Вебмастер: подбор поисковых запросов и анализ рынка
- Вебмастер: малоценные и маловостребованные страницы
- Вебмастер: отличия качественного сайта от некачественного
- Метрика: отчёт «Поисковые запросы»
- Метрика: поиск по сайту
- Search Console: анонимизированные запросы и лимиты выгрузки, 19.10.2022
- Рекомендации по созданию полезного контента
- 15% новых запросов каждый день, Ben Gomes, 25.04.2017
Исследования и данные
- Вордстат, помесячная статистика и топ запросов по слову «кондиционер», снято 26.09.2026
- Search Patterns of Web Users in Russia’s Regions, информационный бюллетень Яндекса, лето 2010
- Сколько запросов ловит одна страница, Ahrefs, Tim Soulo
- Длинный хвост запросов, Ahrefs, Tim Soulo
- Как выбирать низкочастотные запросы, Semrush, Carlos Silva
- Кластеризация запросов, Semrush, Carlos Silva
Документация сервисов кластеризации
- Топвизор, методы кластеризации, справка сервиса
- Rush Analytics, руководство по кластеризации запросов семантического ядра
- KeyAssort, инструкция к сервису
- SearchLab, справка по кластерам
Кейсы
- SearchPilot, Is ‘SEO text’ on category pages a good idea for SEO?, 04.02.2020
- SearchPilot, How does removing SEO text impact SEO performance?, 31.10.2024
- HubSpot, How Content Audits Help The HubSpot Blog Age Backwards, обновлено 03.03.2025
- Как я удалил 65 000 страниц и стал получать больше трафика, Олег Иконников, Хабр
Видео
- Подбор релевантных поисковых запросов, Школа вебмастеров, 19.09.2024
- Создание «идеальной» посадочной страницы, Школа вебмастеров, 19.09.2024
Теги публикации: seo, вордстат, кластеризация запросов, семантическое ядро, структура сайта


Такой подход позволяет увеличить спрос и снизить стоимость каждого клиента
Оптимизация сайта под максимально широкий пул ключевых запросов
Вид поискового продвижения, при котором оплата производится за целевые действия
