Проверка текста на ИИ: наш тест трёх детекторов на четырёх текстах

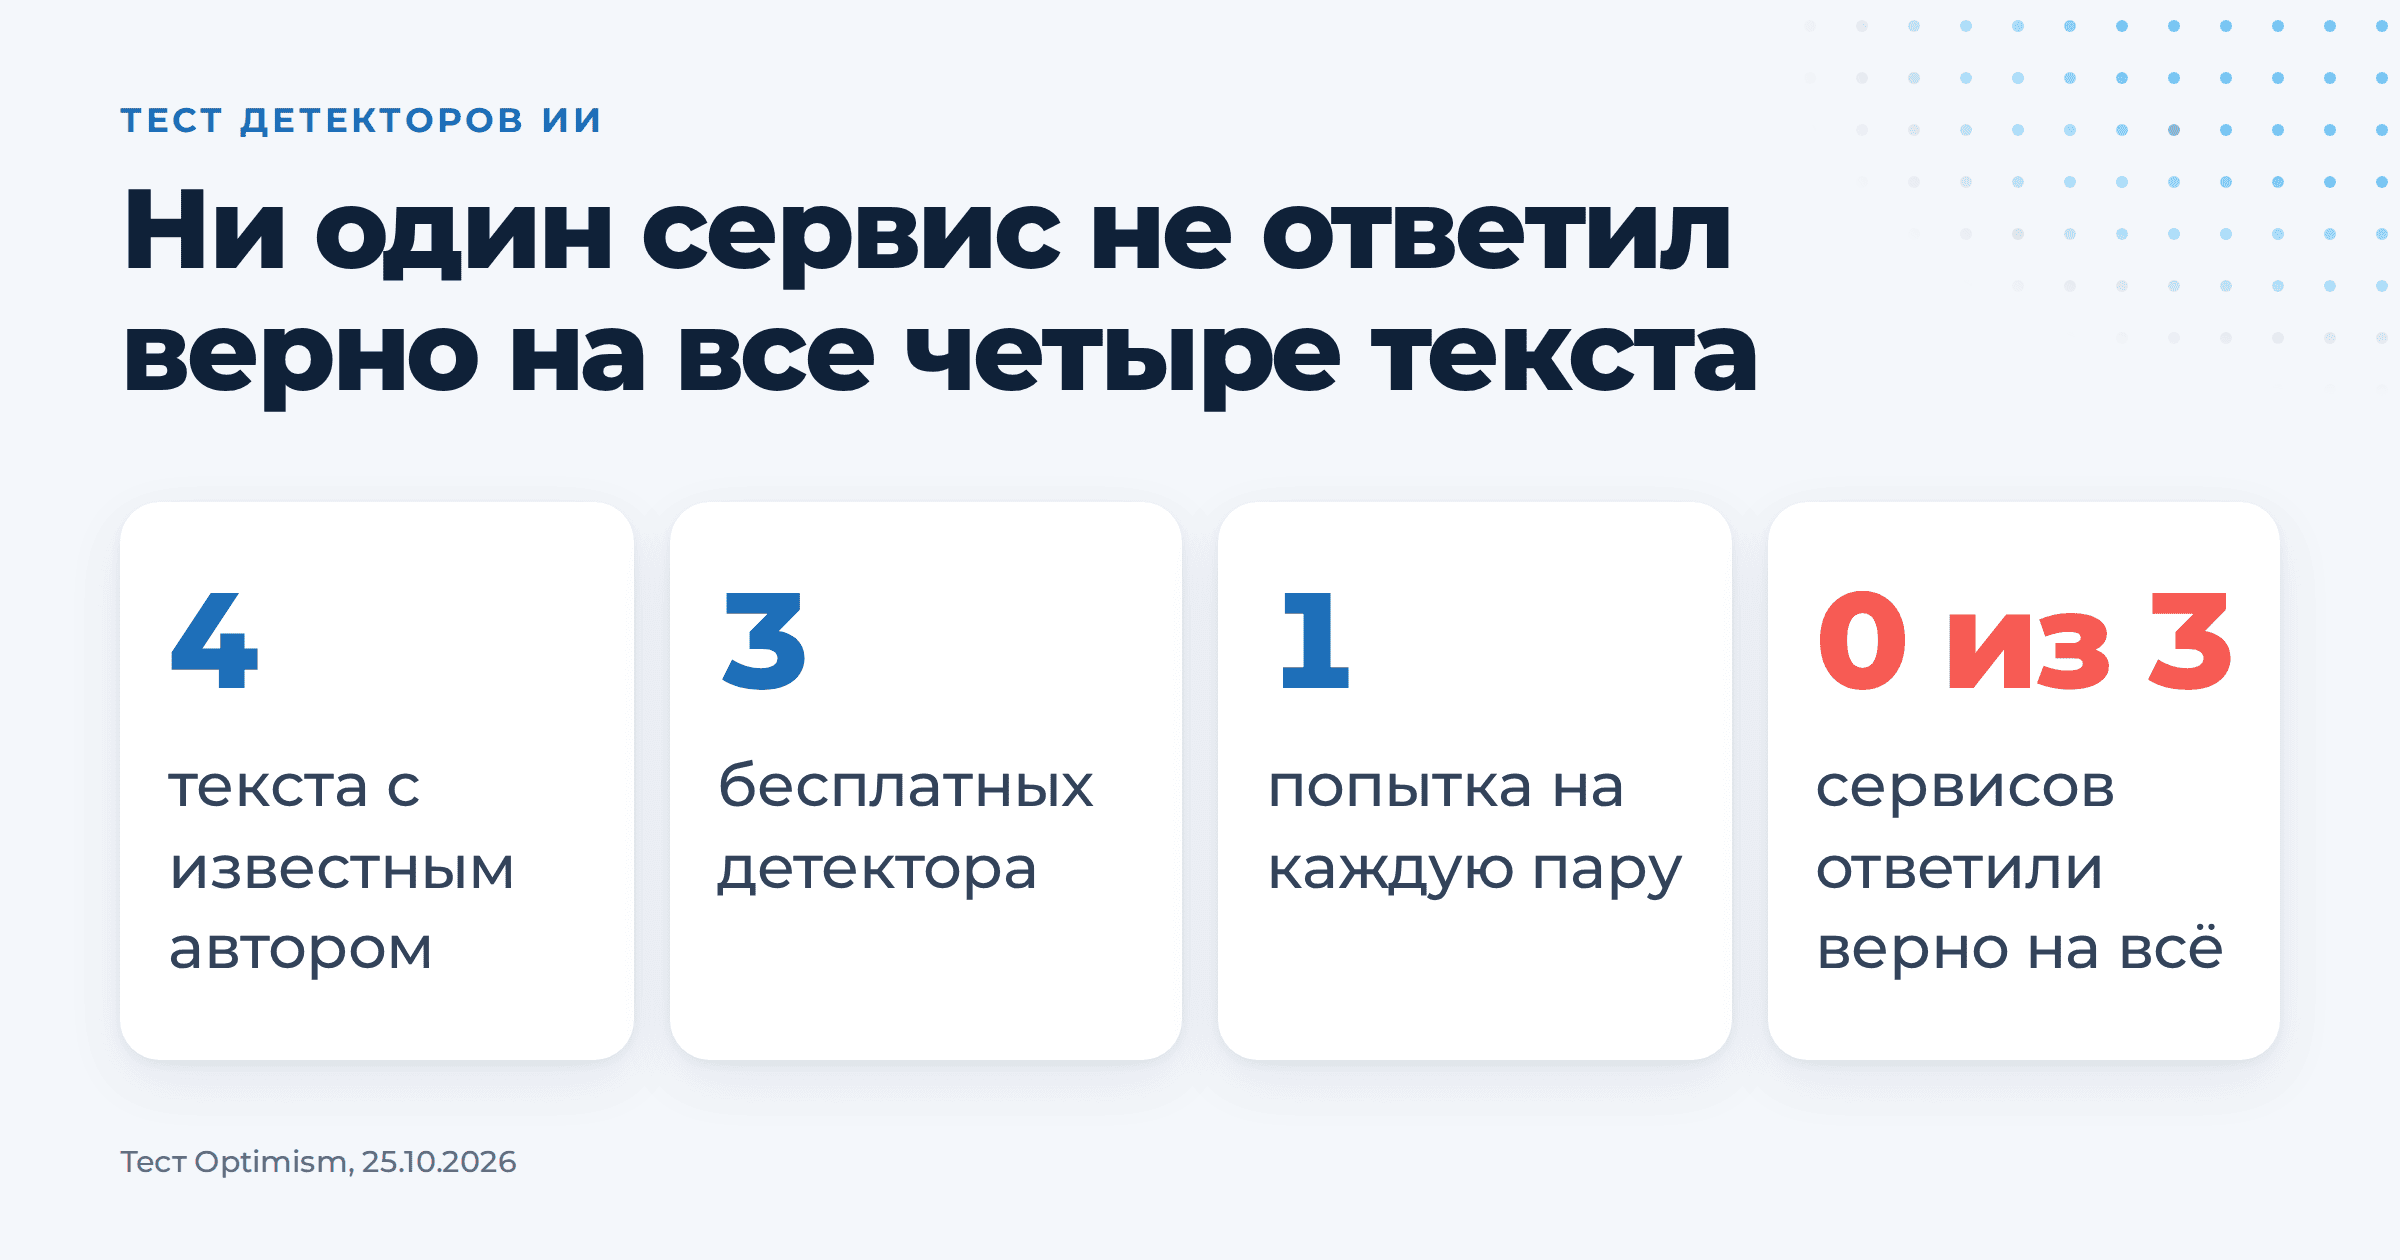
Принимать или браковать текст по проценту детектора нельзя. 25 октября 2026 года мы отправили в Sinonim.org, Текстовод и Aidetector.ru четыре текста, авторство которых знали заранее, и ни один сервис не ответил верно на все четыре. Наш собственный пост 2017 года два сервиса из трёх отнесли к генерации, а оба текста, написанные нейросетями, Aidetector.ru назвал человеческими.
Текстов всего четыре, у каждого сервиса по одной попытке на текст, поэтому точности в процентах и рейтинга из такого теста не получить, и мы их не считали. Зато условия записаны так, что тест повторит любой редактор, а для решения о приёмке текста этого хватает. Ниже дословные ответы сервисов, разбор того, почему классика ничего не проверяет, и чек-лист приёмки, который руководитель может отдать редактору.
Сервисы мы не выбирали по симпатии. На момент проверки все десять первых результатов Яндекса по запросу «проверка текста на ИИ» вели на сами детекторы, и трёх участников мы взяли из этой выдачи до того, как увидели первый ответ.
Как мы проверяли, чтобы тест можно было повторить
Мы взяли четыре текста, авторство которых знали до отправки, причём два из них написали нейросети, а два люди. Перед отправкой каждый текст получил цифровой отпечаток, хеш SHA-256, и перед каждой вставкой мы сверяли этот отпечаток прямо в поле ввода сервиса. Каждый текст ушёл в каждый сервис один раз, в бесплатном режиме, без регистрации и платных функций.
| Код | Что за текст | Кто написал | Объём |
|---|---|---|---|
| A1 | вымышленная сцена про мастерскую и сломанный принтер | Claude, без правки человеком | 1 839 знаков, 264 слова |
| A2 | заметка о том, зачем малому бизнесу CRM и как её выбрать | GPT, без правки человеком | 2 372 знака, 298 слов |
| H1 | фрагмент рассказа Чехова «Хамелеон», 1884 год | А. П. Чехов, текст из Викитеки | 2 128 знаков, 333 слова |
| H2 | начало нашего поста «Почему мы не рекомендуем делать оптимизацию сайта своими силами» | автор блога Optimism | 2 127 знаков, 273 слова |
Сцену A1 Claude писал в рабочей сессии, где уже действовали наши редакционные правила русского стиля, поэтому называть её сырым ответом модели было бы нечестно. Заметку A2 модель GPT написала по заданию в одну фразу, где мы попросили связный текст на 280-320 слов для блога агентства, без заголовков и списков. Ни один из двух текстов потом не правил человек.
Пост H2 вышел у нас в блоге 26 марта 2017 года, последний раз его правили 27 марта 2019-го, а для теста мы убрали из него только разметку, не трогая слов. ChatGPT запустили только 30 ноября 2022 года, так что у нас есть сильное, хотя и не абсолютное основание считать текст человеческим.
Отпечаток совпал с исходным во всех двенадцати отправках, поэтому разницу ответов нельзя списать на то, что какому-то сервису достался другой вариант текста. Отказ сервиса или оборванную проверку мы заранее договорились не считать нулём процентов, и повторно один и тот же текст мы не отправляли и под ответ не подгоняли.
Текстов четыре, попытка на каждую пару «текст и сервис» одна, режимы только бесплатные. Повторный прогон того же текста мог дать другой ответ, этого мы не проверяли. Точность сервисов, их места в рейтинге и долю ложных срабатываний на рынке из такой выборки не вывести. Тест показывает конкретные ошибки на конкретных текстах, и только.
Что ответили сервисы, дословно
Сошлись три сервиса только на Чехове, а на остальных трёх текстах ответы разошлись. Текстовод нашёл генерацию в обоих текстах нейросетей и в нашем человеческом посте. Aidetector.ru назвал человеческими оба модельных текста, а про пост 2017 года написал, что текст скорее сгенерирован ИИ. Sinonim.org поставил двум модельным текстам по 10%, а человеческому посту 30%, то есть больше. Верного ответа на все четыре текста нет ни у одного сервиса.
| Текст | Sinonim.org | Текстовод | Aidetector.ru |
|---|---|---|---|
| A1, Claude | 10%, «Текст написан с высокой вероятностью человеком» | «Обнаружена генерация ИИ», явные признаки ИИ 100% | «Похоже, текст написан человеком», 80,8% «Написано человеком» |
| A2, GPT | 10%, в пояснении «гладко и логично, что характерно для ИИ» | «Обнаружена генерация ИИ», явные признаки ИИ 100% | «Похоже, текст написан человеком», 87,0% «Написано человеком» |
| H1, Чехов | 0%, «написан с большой вероятностью человеком» | «Значимых признаков ИИ не обнаружено», явные признаки ИИ 0% | «Похоже, текст написан человеком», 100,0% «Написано человеком» |
| H2, наш пост 2017 года | 30%, в пояснении «характерно для контента, создаваемого ИИ» | «Обнаружена генерация ИИ», явные признаки ИИ 100% | склоняется к тому, что текст сгенерирован ИИ, 44,5% «Написано человеком» |
Проценты стоят рядом с подписями намеренно, потому что у каждого сервиса своё число значит своё. У Aidetector.ru кроме доли «Написано человеком» есть категории «Повышенное внимание» и «Высокий риск AI генерации». Например, 19,2% у сцены A1 относятся к повышенному вниманию, поэтому называть их вероятностью ИИ нельзя. Сводить проценты трёх сервисов к одной шкале или усреднять их мы не стали.
Под вердиктом для поста 2017 года Текстовод показал кнопку «Сделать текст человечнее», то есть сервис сначала отметил человеческий текст как генерацию и тут же предложил его переделать. Помните об этой связке, когда кто-то предлагает заплатить за «очеловечивание», чтобы отчёт детектора выглядел лучше.
Почему ошибка на человеческом тексте дороже пропуска
Пропущенный модельный текст обходится дешевле, чем зря обвинённый автор. Наш пост 2017 года написан человеком задолго до запуска ChatGPT, и всё равно Текстовод показал у него 100% явных признаков ИИ, а Aidetector.ru склонился к тому, что его сгенерировал ИИ. Это один текст, но и сам Aidetector.ru предупреждает, что в формальных жанрах его отчёт ничего не доказывает, а деловой текст с перечислениями и привычными оборотами относится именно к таким жанрам.
Представим, что такой текст принёс ваш штатный копирайтер, который пишет для компании не первый год, и отчёт с красной плашкой тут же превращает разговор о качестве в разговор о честности. Автору нечем доказать, что он писал сам, кроме черновиков, а вам нечем доказать обратное, кроме процента. Хороший автор после такого разговора может просто уйти.
Sinonim.org в пояснении к нашему посту процитировал из него обороты «не такое простое занятие, каким кажется на первый взгляд» и «получается далеко не всегда» и написал, что они «могут быть сгенерированы». Сгенерировать, конечно, можно любую фразу, но так писали деловые блоги задолго до нейросетей, и шаблонный оборот говорит о стиле, авторства он не доказывает.
Сами сервисы это понимают, и Aidetector.ru под каждым отчётом пишет, что результаты проверки это «не доказательство AI-генерации», особенно в формальных жанрах и хорошо отредактированных текстах. Там же он советует смотреть черновики, версии файла, сравнение со стилем автора и предметную экспертизу. Текстовод под вердиктом предлагает автору показать, как рос текст, и вести дневник работы над ним, так что оба сервиса сами отправляют вас к проверкам, которые от процента не зависят.
Почему детекторы в целом так ошибаются и чем это оборачивается для компаний, мы подробно разбирали в статье об ИИ-детекторах, которые вредят бизнесу и авторам. Здесь важнее практический вывод, что отчёт, который обвиняет человеческий текст, нельзя класть в основу разговора с автором.
Почему верный ответ на классике ничего не доказывает
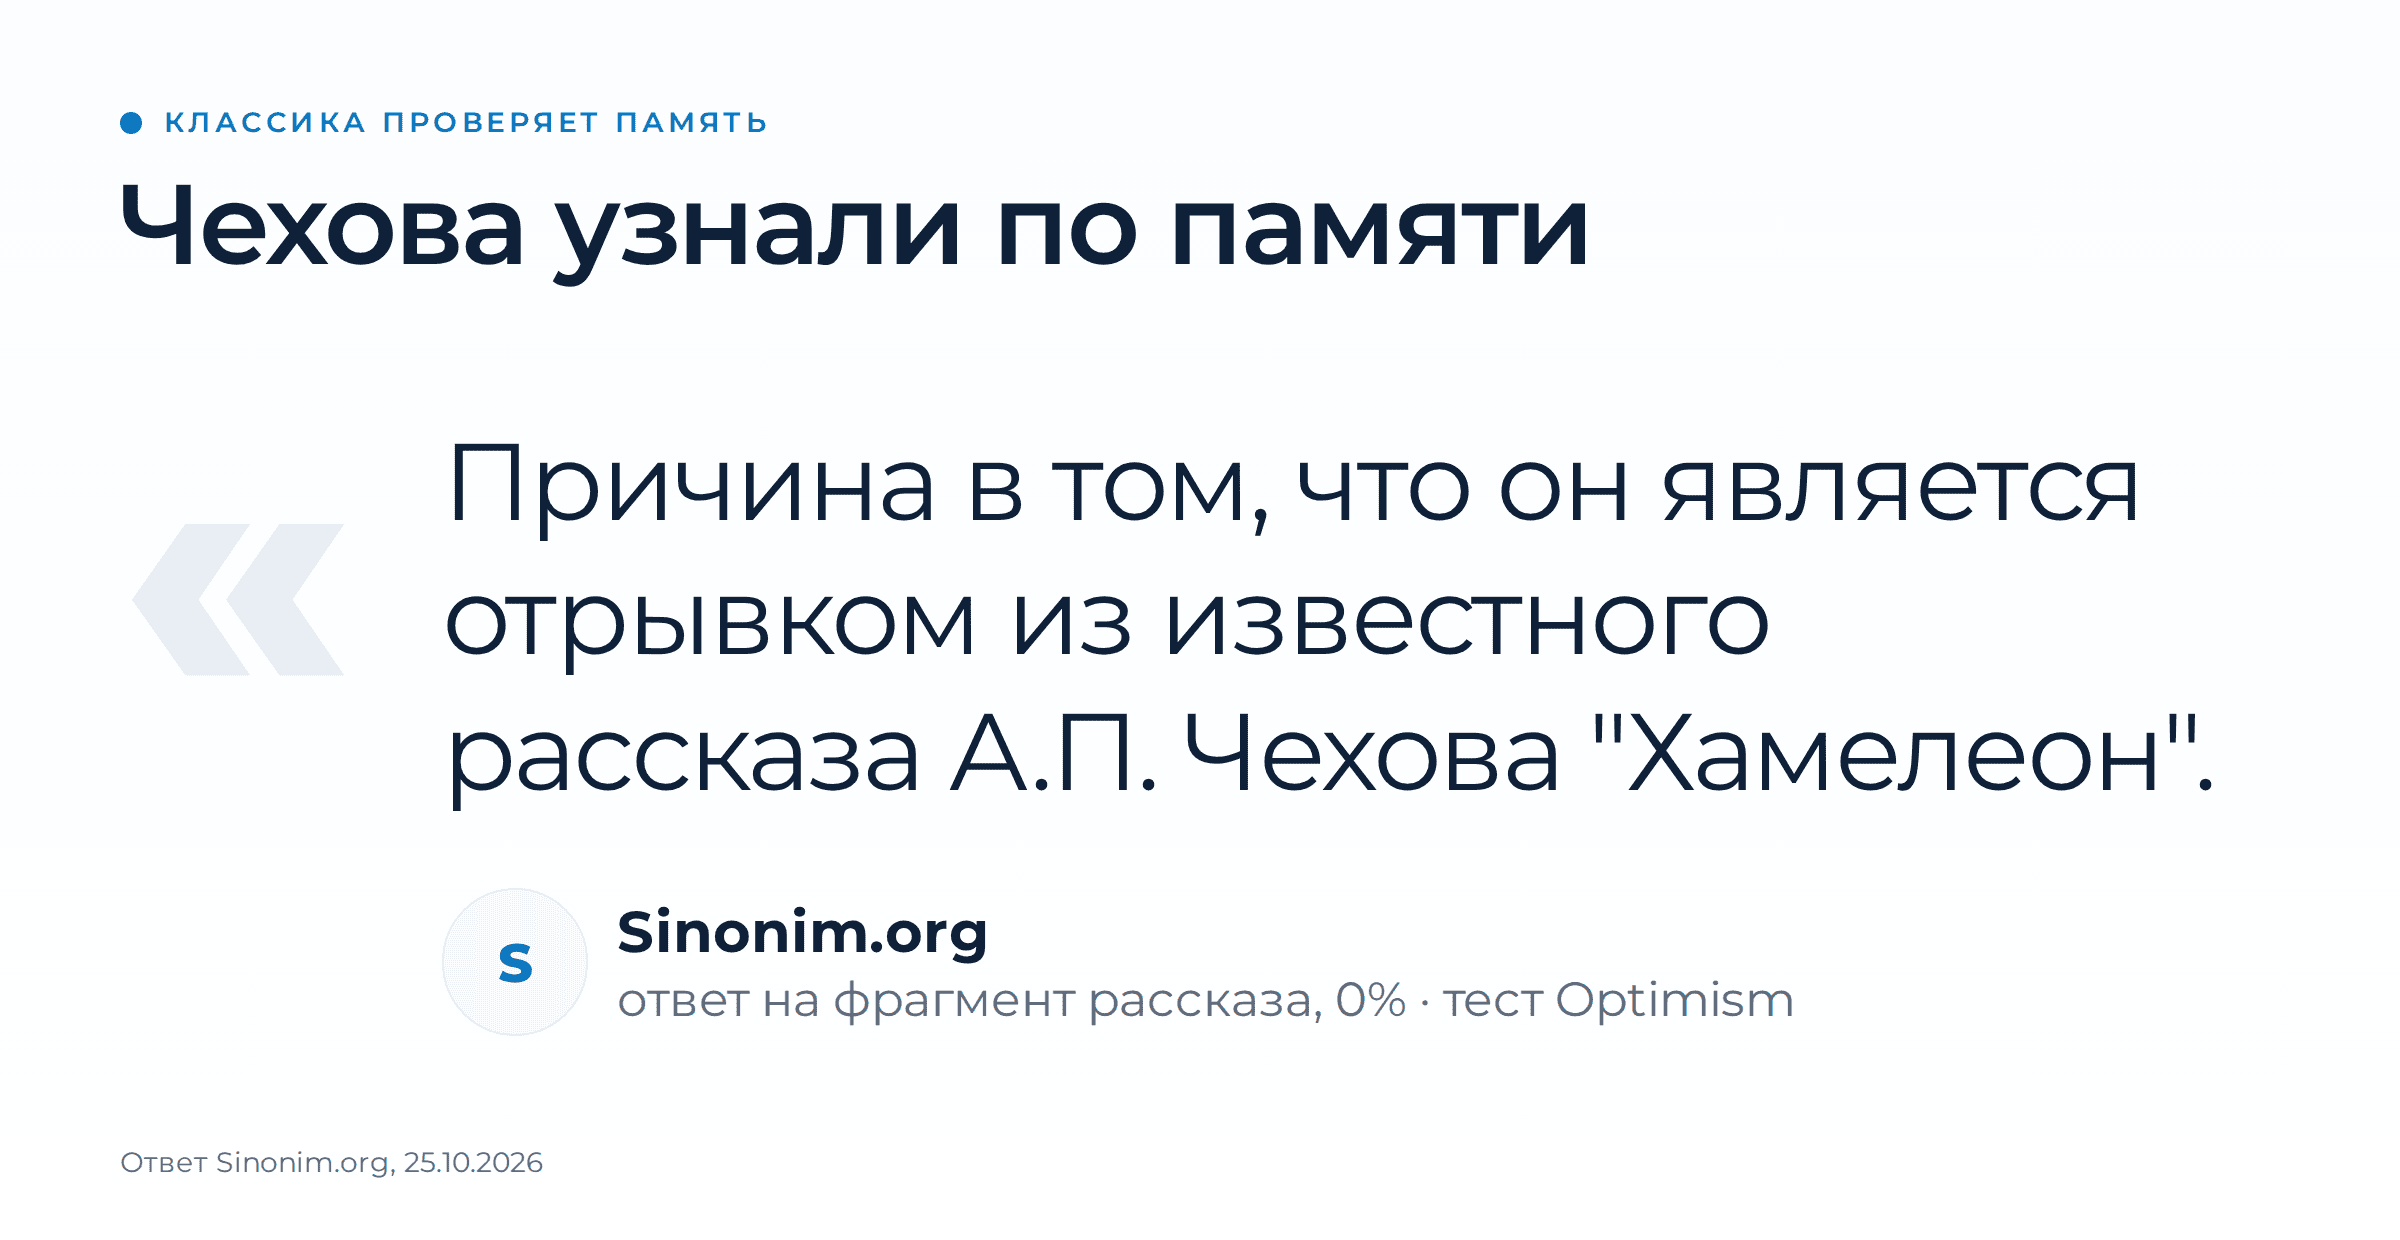
Чехова признали человеческим все три сервиса, а Sinonim.org прямо назвал рассказ. Так проверяется память сервиса. Знаменитый текст детектор мог встречать много раз, поэтому верный ответ на нём ничего не говорит о том, что сервис скажет про письмо вашего менеджера или статью нанятого автора. Тот же Sinonim.org дал нашему человеческому посту 30%.
Проверить сервис на классике хочется первым делом. Вставляешь страницу Чехова или Толстого, видишь «написано человеком» и начинаешь доверять. Наш тест показывает, почему так делать не стоит, ведь свой ответ про «Хамелеона» Sinonim.org объяснил тем, что узнал рассказ и стиль Чехова. Про письма и статьи вашей компании у сервиса такого знания нет.
Для калибровки годится только текст, которого сервис не мог видеть, например ваш собственный старый материал, написанный до 2022 года и без закрытых данных. Если таких текстов нет, честнее вообще не калибровать детектор, чем калибровать его на классике и получать ложную уверенность.
Что смотрят Яндекс и Google вместо процента
Ни Яндекс, ни Google в своих документах не обещают наказывать текст за участие нейросети. Оба говорят о пользе для читателя, а расходятся в акценте. Яндекс прямо пишет, что нейросеть не должна подменять автора, а Google проводит границу по цели, ради людей сделан текст или ради позиций в выдаче. Процента детектора нет ни в одном из этих критериев.
Яндекс подробно описывает свой подход в справке Вебмастера «Какие аспекты влияют на ранжирование в Поиске и попадание в ответы Алисы AI». «Уникальность текста сама по себе не гарантирует, что контент действительно ценен», говорится в разделе об оригинальности. Про нейросети там же сказано, что они «могут быть отличным помощником для автора, но не должны подменять его, лишая текст смысловой новизны, авторского стиля и экспертизы». Вопрос для самопроверки Яндекс предлагает один, помогла ли страница пользователю решить его задачу или проблему. Что именно Яндекс считает мусорным нейротекстом, мы разбирали в отдельной статье о нейротексте.
Google сформулировал свою позицию в блоге Search Central в феврале 2023 года. «Качество контента для нас гораздо важнее того, каким способом он создан», пишет компания. «Надлежащее использование искусственного интеллекта или инструментов автоматизации не противоречит нашим правилам», уточняет она там же, а нарушением считает текст, сделанный в основном ради управления позициями в выдаче.
Расхождение стоит назвать прямо. Яндекс смотрит на вклад автора, на новизну мысли, стиль и экспертизу. Google смотрит на цель текста, но для владельца бизнеса вывод из обоих документов один. Поисковики оценивают, что текст даёт читателю, и отчёт детектора к этой оценке ничего не добавляет.
Как принимать текст у автора без процента
Принимайте текст по тому, что можно проверить. Цифры, даты и имена сверяются с источником, обещания с условиями продукта, польза с вопросом читателя. Если вам важно, как текст сделан, договоритесь об этом до заказа и попросите черновики или пояснение автора. Тогда спор идёт о конкретных абзацах, и его можно закрыть правкой.
Порядок удобно держать одинаковым для штатных авторов и подрядчиков, сначала договорённость, потом факты, потом польза, и только в конце разговор о спорных местах. Детектор, если редактор к нему привык, можно оставить последним и необязательным шагом, и тогда его отчёт становится поводом перечитать абзац, а не основанием для отказа.
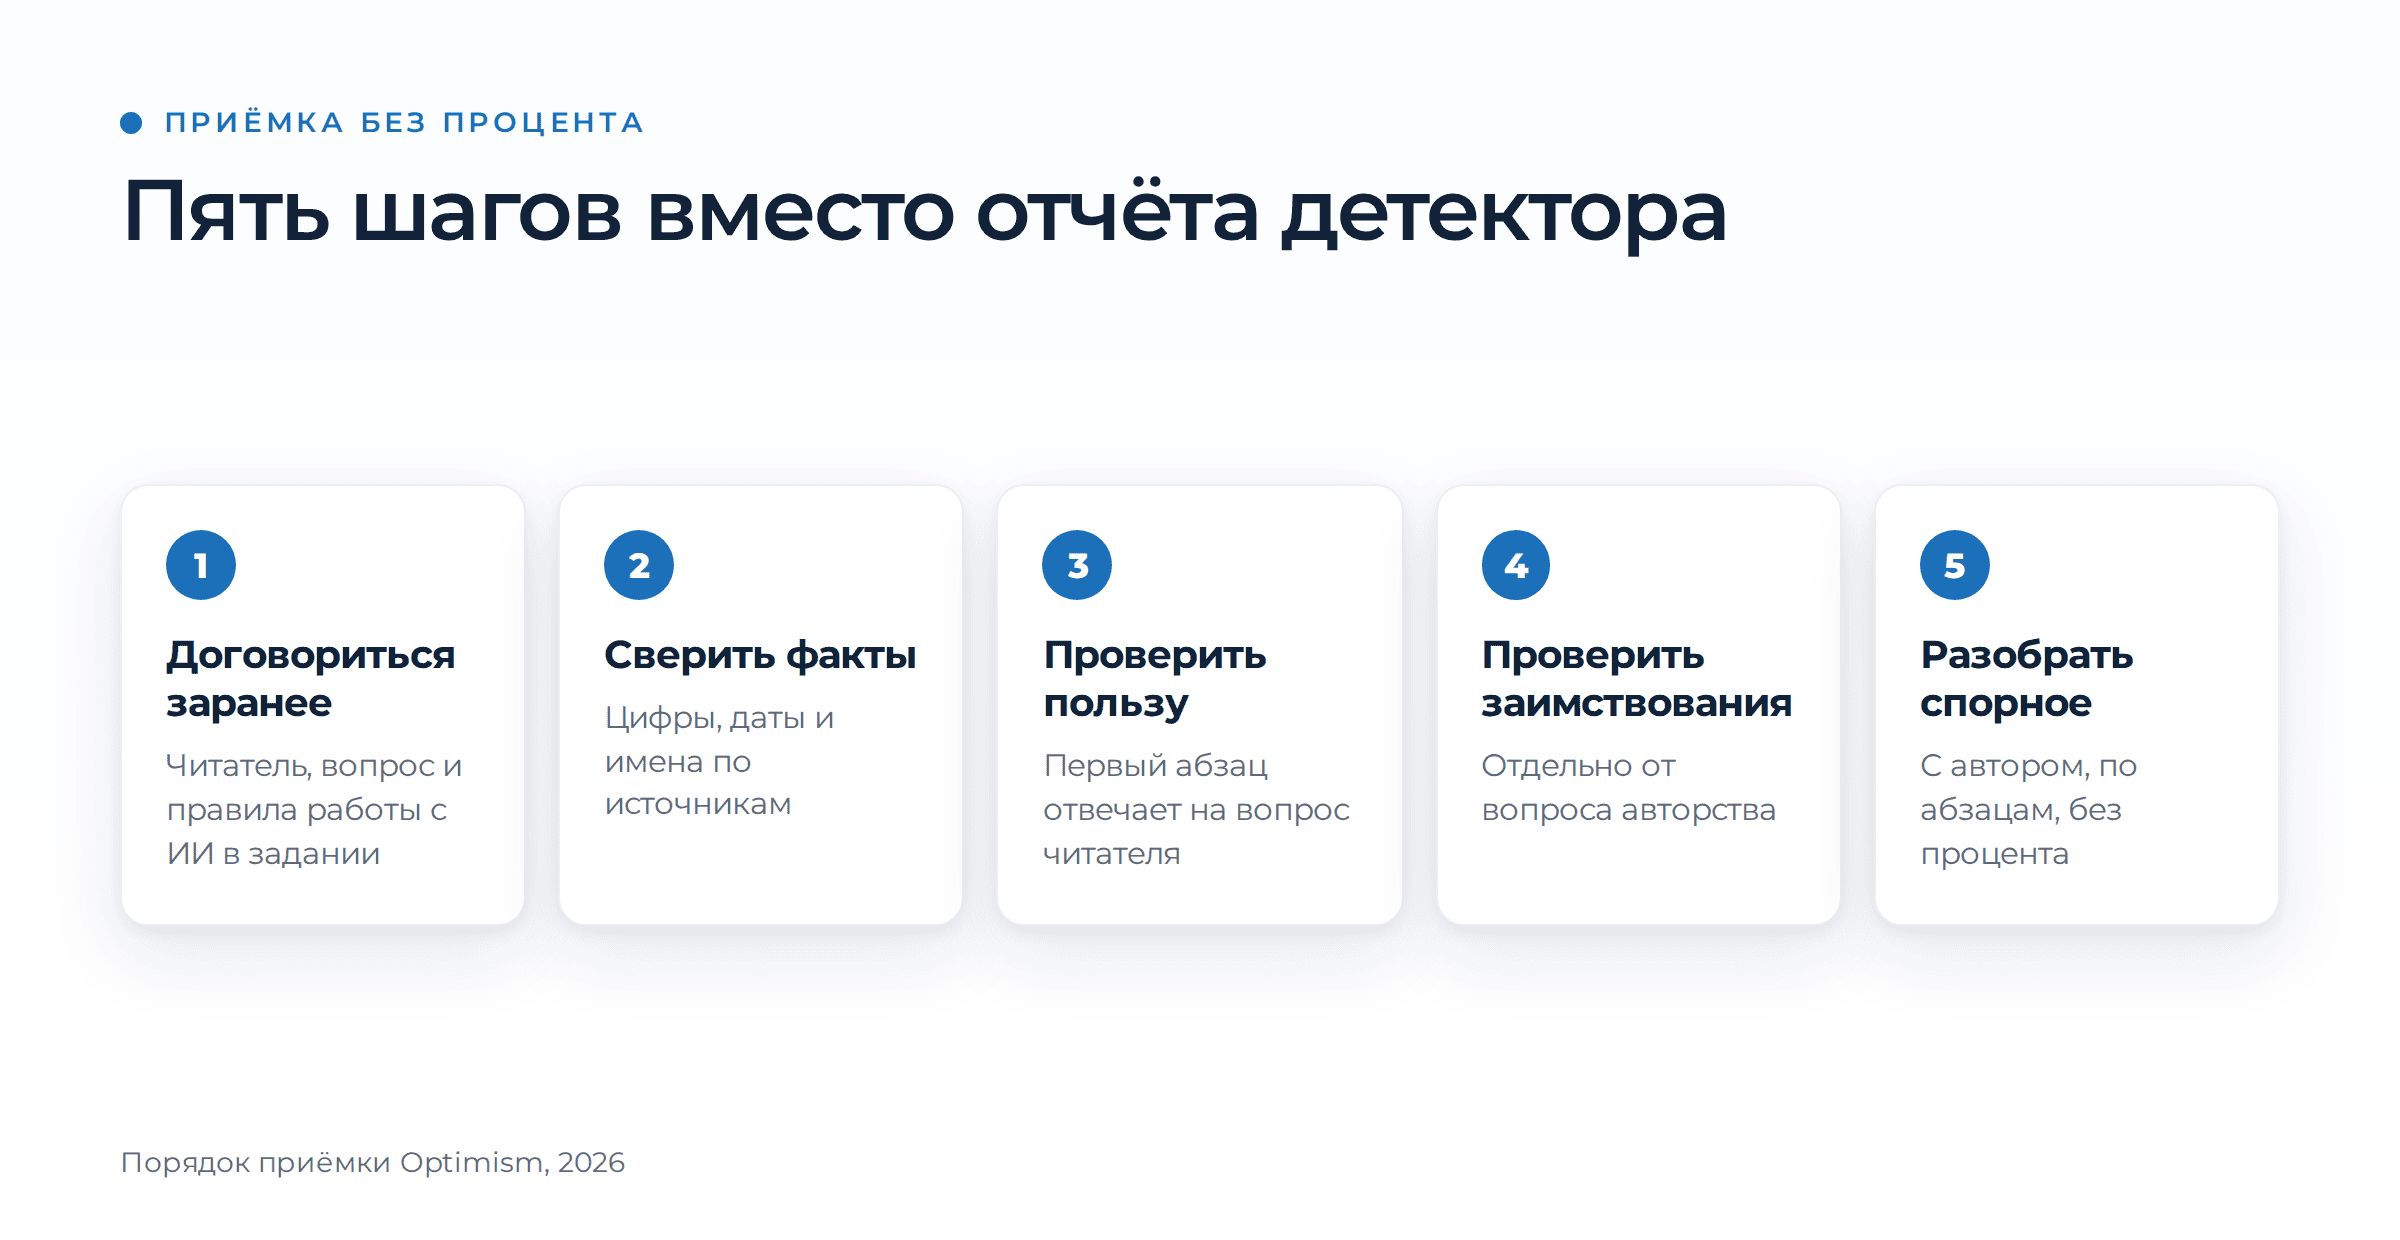
Чтобы этот порядок не остался благим намерением, его стоит записать и отдать тому, кто принимает тексты, и список ниже рассчитан на редактора, который проверяет и своих авторов, и подрядчиков.
чек-листЧек-лист приёмки текста для редактора7 пунктов, для штатных авторов и подрядчиковРаскрыть
- В задании записаны читатель, его вопрос и правила работы с ИИ. Где нейросеть допустима, например в черновом плане или переводе, и где нет, записано заранее, иначе претензия «писал нейросетью» не имеет опоры.
- У каждой цифры, даты и имени есть источник. Откройте его и найдите нужную фразу глазами, потому что ссылка на главную страницу сайта источником не считается.
- Цитаты дословные, их сверяют с документом, особенно цитаты законов, справок поисковиков и слова экспертов.
- Обещания совпадают с продуктом, то есть сроки, цены, условия и обещанные результаты в тексте не шире, чем в договоре и на сайте.
- Первый абзац отвечает на вопрос читателя, а если ответ спрятан в середине, текст возвращается на правку, кто бы его ни писал.
- Заимствования проверены отдельно от авторства, потому что совпадение с чужим текстом решается проверкой уникальности и оформлением цитат.
- Спорные места разобраны с автором по абзацам. Замечание называет конкретный фрагмент и желаемый результат, без ссылки на процент сервиса.
Процент детектора я не обсуждаю. Покажи источник к каждой цифре и объясни, на какой вопрос читателя отвечает первый абзац.
Перед тем как вставить текст в открытую форму любого сервиса, проверьте, можно ли его туда передавать, ведь договоры, клиентские материалы и переписку в бесплатные детекторы не отправляют. В наш тест ничего подобного не попало, только опубликованный пост, классика и два текста, написанные специально для проверки.
Как повторить тест на своих текстах
Повторить наш тест может любой редактор, и собственный результат убеждает лучше чужого. Нужны четыре текста с известным происхождением, два-три детектора и таблица для ответов. Главное правило одно, каждый вердикт сравнивают с настоящим автором текста, а проценты разных сервисов между собой не сравнивают.
- Подберите тексты. Два пусть напишут нейросети по простому заданию, один возьмите из своих материалов, написанных до 2022 года, и один из классики как контроль памяти.
- Заморозьте их. Сохраните каждый текст файлом и запишите его хеш SHA-256 или хотя бы число знаков, а между отправками тексты не правьте.
- Выберите сервисы до первого ответа, иначе легко оставить в таблице тех, кто ответил удобно.
- Отправьте каждый текст в каждый сервис один раз в одном и том же режиме, лучше бесплатном и без регистрации.
- Сохраните ответ целиком, с подписью сервиса рядом с числом, иначе через неделю никто не вспомнит, что значили эти проценты.
- Сверьте вердикты с авторством и запишите отказ сервиса отказом, ноль процентов ему не ставьте.
Если результаты на ваших текстах совпадут с нашими, у редактора появится собственный довод, почему процент не годится для приёмки. Если не совпадут, это тоже знание о сервисе, которым он пользуется. В обоих случаях решение о тексте остаётся за фактами, источниками и пользой для читателя.


Такой подход позволяет увеличить спрос и снизить стоимость каждого клиента
Оптимизация сайта под максимально широкий пул ключевых запросов
Вид поискового продвижения, при котором оплата производится за целевые действия
